
大型语言模型的检索与记忆原语
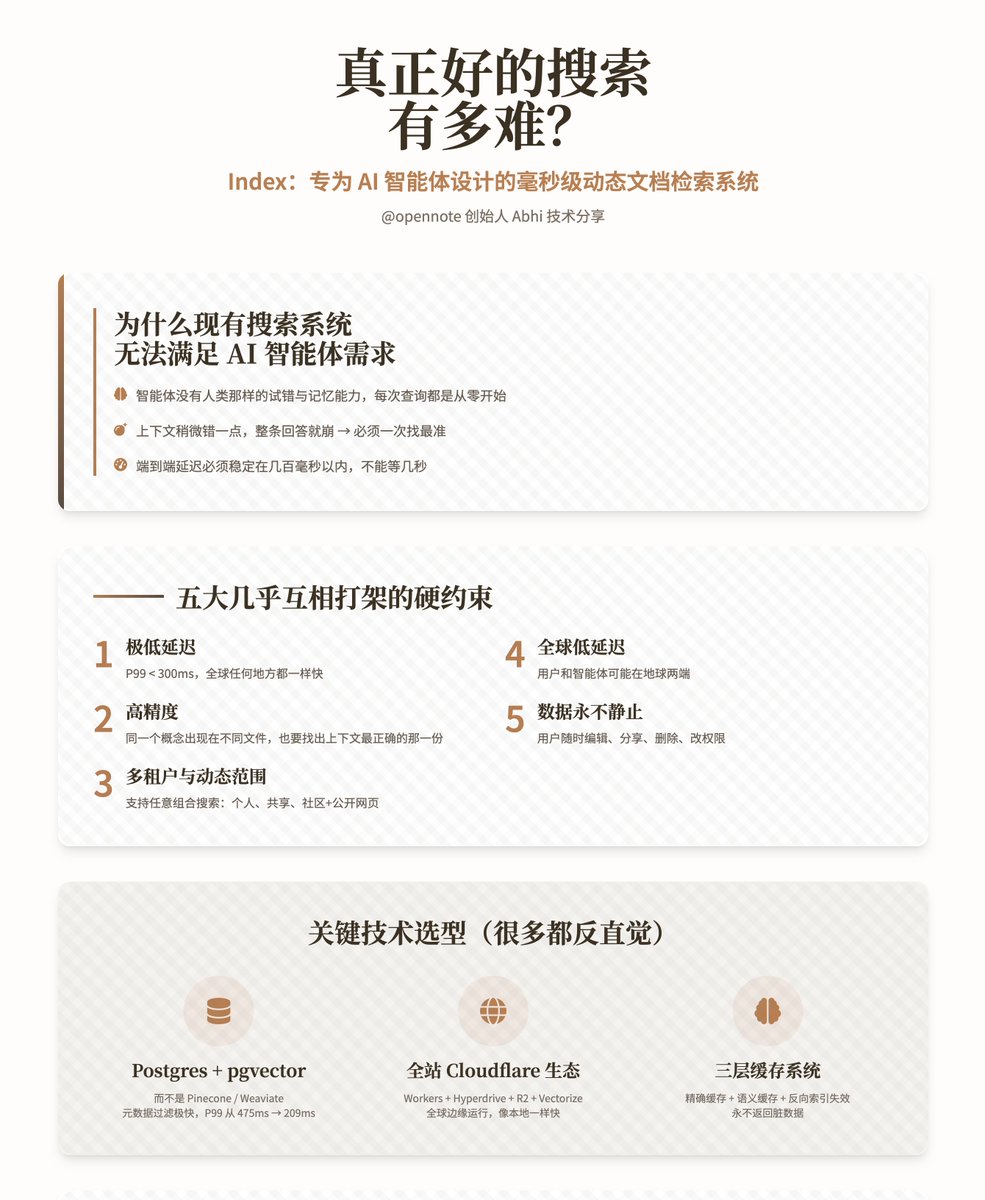
新的检索和记忆系统旨在实现毫秒级的高精度代理检索和持久的大型语言模型记忆。
Key insights
Opennote Index 针对代理的毫秒动态检索
Opennote 描述了 Index,这是一个为 AI 代理优化的检索系统,具有 P99 < 300ms 的延迟。Index 使用 Postgres(pgvector/pg_trgm/tsvector)而非专用向量数据库,以实现高效的元数据预过滤、混合关键词/向量搜索、多租户动态过滤以及通过 Cloudflare Workers 实现的边缘分布式运行时。数据摄取管道对数据块进行哈希,仅重新计算变化的嵌入,并集成了三级缓存和精确失效机制,以确保数据的新鲜度。
Memori 为大型语言模型和代理提供 SQL 原生的开放记忆原语
Memori 是一个开放的记忆引擎,与标准 SQL 数据库集成,为大型语言模型提供持久的、可查询的记忆。它拦截大型语言模型的调用,以注入短期记忆,在响应后提取实体和事实,定期运行“意识”任务以提炼长期记忆,并支持意识/自动/组合记忆模式,具有一行集成。
混合设计偏向于 SQL 用于元数据、向量融合和操作控制
这两个系统都偏向于使用 SQL 原语进行元数据过滤、操作语义(UPSERT/DELETE)、多租户隔离和精确缓存失效,认为这些特性提供了比许多向量存储更好的延迟、一致性和动态过滤。