
大型语言模型的理解与思维链监控
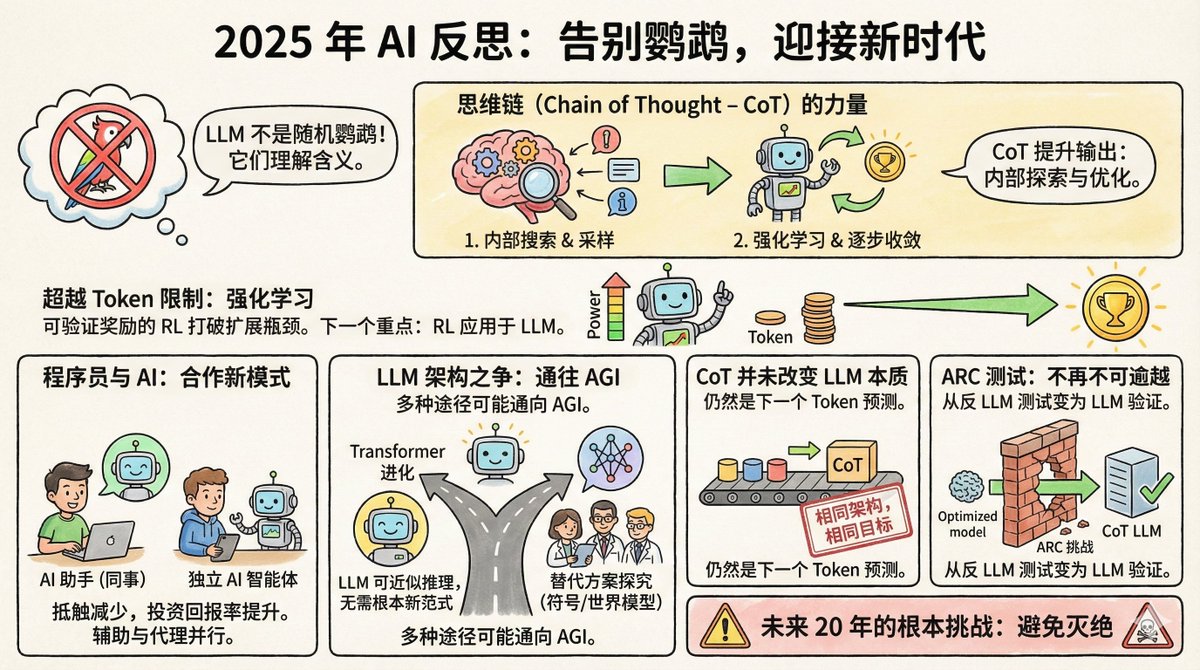
两项分析认为大型语言模型(LLMs)现在形成了内部概念表示,而思维链(CoT)监控是一种可衡量的安全工具。
Key insights
大型语言模型不仅仅是随机鹦鹉
萨尔瓦托雷·圣菲利波报告称,到2025年,'随机鹦鹉'的批评已基本消失;实证证据包括大型语言模型在法律、医学和数学考试中超越大多数人类的表现,以及逆向工程显示内部概念表示。他引用了杰弗里·辛顿的论点,认为预测下一个标记需要句子级别的理解。圣菲利波将此视为对模型理解的简单否认的实际终结,同时指出哲学争议仍然存在。
思维链是一个被低估的突破
圣菲利波认为,思维链(CoT)提示通过在答案之前揭示内部表示来改变模型行为,并且与强化学习结合时,它们引导模型朝向可靠的多步骤解决方案。他解释说,思维链通过提示模型采样和突出相关概念('在草稿纸上列大纲')来工作,而逐标记的强化学习则引导生成朝向收敛推理路径。
开放AI:思维链监控提高安全性
开放AI的研究提出了一个思维链监控框架和13种评估方法,显示更长的内部推理可以增加外部监控性。研究结果包括一个'监控性税'权衡——较小的模型在较长推理下比更大的浅层模型更容易监控,并且有针对性的后续问题可以引发更清晰的内部推理。论文报告称,在当前规模下,强化学习并没有显著降低思维链的透明度。
计算和自我监督的强化学习扩展训练信号
圣菲利波指出,可验证奖励任务(例如程序优化、定理证明)提供了近乎无限的训练信号,允许能力在超出人类文本限制的情况下持续增长;他将此与基于强化学习的推理改进联系起来,并建议不必放弃变换器以实现进步。