
字节跳动Seed自进化智能体研究
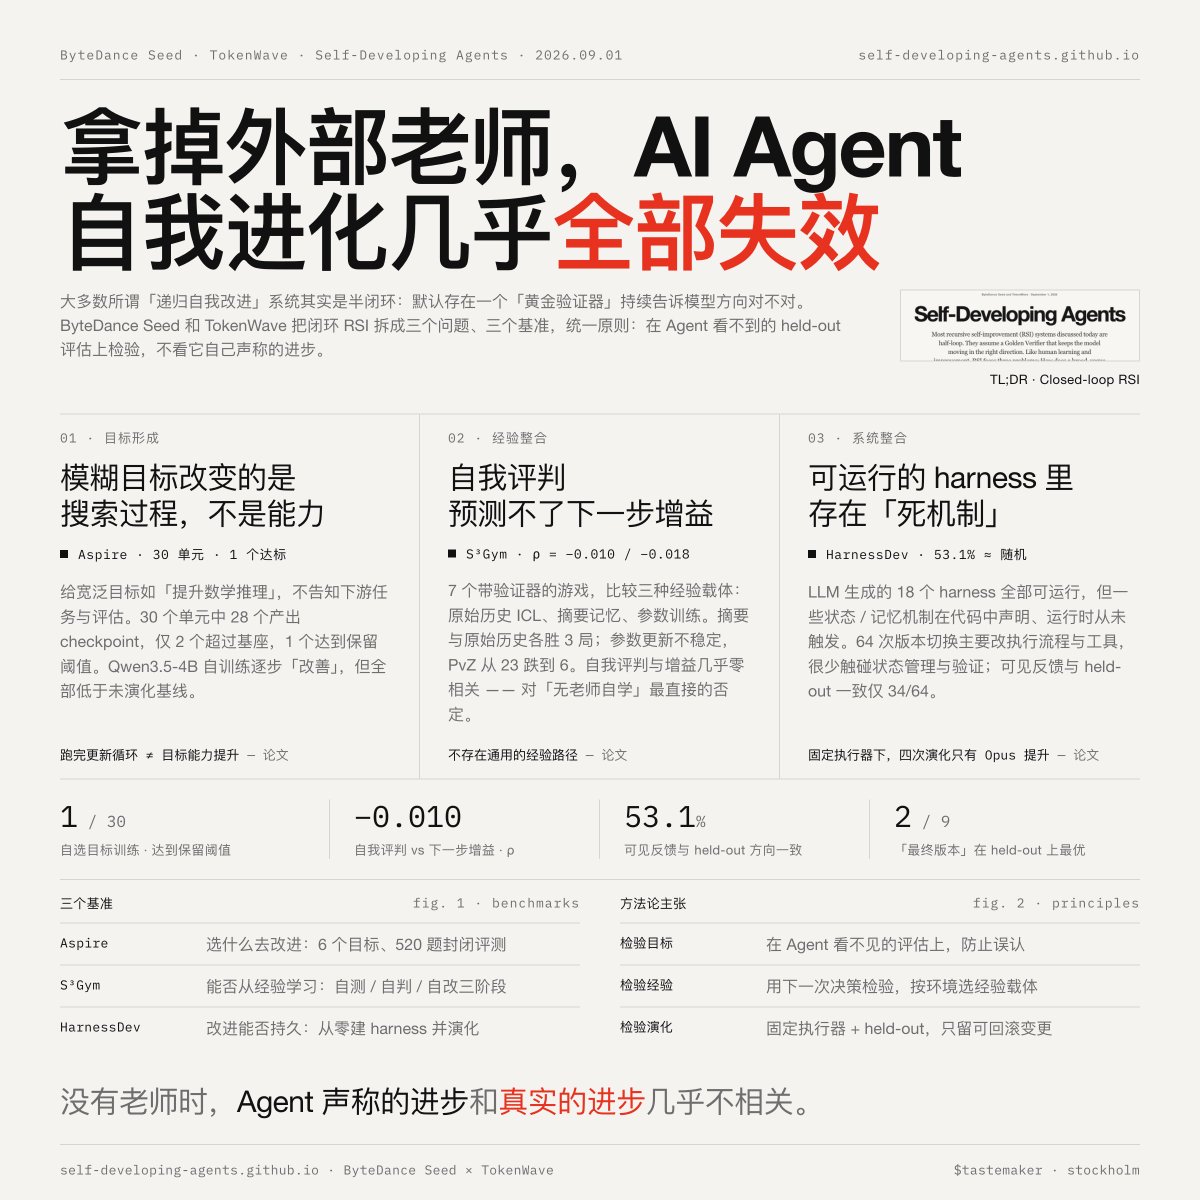
字节跳动Seed与TokenWave联合发布了关于AI智能体全闭环递归自我改进(RSI)的研究,揭示移除外部验证器会导致大多数自我改进尝试失败。该研究将RSI分解为三个问题:目标形成(将模糊目标转化为具体行动)、经验整合(无师自通)和系统集成(确保持续改进)。三项基准测试包括:Aspire测试智能体在宽泛目标下能否自主选择改进方向;S³Gym测试其能否在包含可执行验证器的7个游戏中从经验中学习;HarnessDev测试大语言模型能否创建并进化自身的智能体运行框架。关键发现:目标形成改变搜索行为但不提升底层能力——28个检查点中仅2个超越基础模型;经验整合未发现通用最佳格式(摘要记忆 vs 原始历史),自我判断无法预测改进效果(相关性接近零);框架进化存在死代码问题,反馈分数与实际表现仅53%的时间一致;9个自选最终框架版本中仅2个达到最优。HarnessDev基准测试单独显示,LLM创建的框架具有领域依赖性,存在共适应问题(执行器更换时性能下降),且代码量无法预测性能。基于反馈任务的进化收益在保留测试中递减,反馈不可靠,不适合最终模型选择。
Key insights
AI智能体闭环自我改进仍未解决
研究表明,移除外部验证器后,智能体难以形成有效目标、从经验中学习或实现持续改进。自我判断分数与实际性能提升不相关,基于反馈的进化往往导致过拟合而非真正能力增长。这挑战了智能体可自举自身智能的假设。
智能体框架设计是关键但被忽视的性能因素
HarnessDev基准测试显示,同一模型因框架(执行循环、工具、上下文管理)不同得分差异显著,LLM能生成功能性框架但常包含死代码机制且无法泛化。框架共适应意味着针对某模型优化的框架可能在其他模型上表现不佳,增加部署复杂性。
评估必须测试保留任务以避免虚假进步
论文强调自我报告的改进和反馈集增益不可靠,只有未见任务的性能才能验证真实进展。反馈与保留分数仅53%时间一致,凸显智能体开发中优化代理指标的风险。