
安德烈·卡帕西的2025年大型语言模型回顾
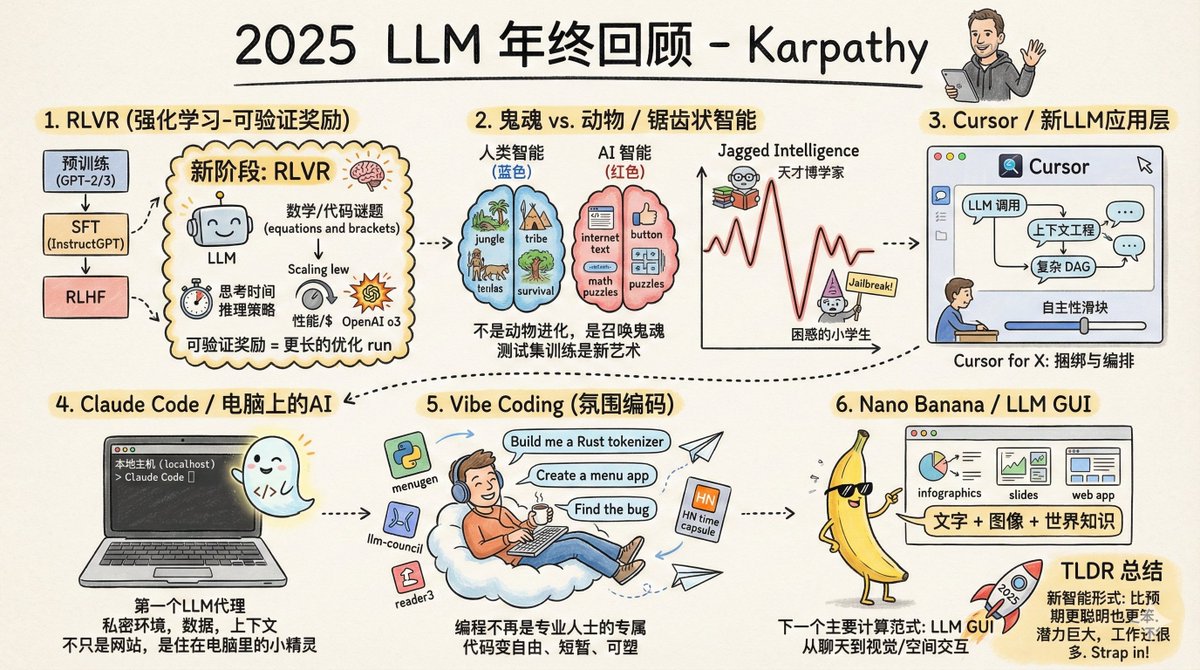
卡帕西发布了2025年大型语言模型的回顾,描述了六个范式转变。- RLVR被添加为第四个训练阶段(来自可验证奖励的强化学习)。- RLVR在数学和代码等可验证答案的环境中训练模型。- RLVR推动了新兴的多步骤推理,并将计算资源重新分配到强化学习阶段。- 大型语言模型的智能是“锯齿状的”(幽灵与动物),在可验证领域具有高技能。- 基准信任度下降,因为测试是可验证和可优化的。- Cursor证明了一种新的大型语言模型应用层:上下文工程和多模型编排。- Claude Code展示了使用用户环境和工具的本地运行代理。- Vibe编码:自然语言驱动的编码使编程民主化。- Gemini Nano Banana标志着大型语言模型图形用户界面时代的到来,具备文本与图像融合的能力。- 卡帕西:当前模型比预期更聪明也更愚蠢;仍然存在大量未开发的潜力。
Key insights
RLVR成为新的标准训练阶段
卡帕西将来自可验证奖励的强化学习(RLVR)视为在预训练、监督微调和RLHF之后增加的第四个训练阶段。RLVR在具有客观正确性的环境中训练模型(例如,数学问题、可运行代码),在这些环境中,正确的输出会产生可验证的奖励。他表示,RLVR使模型能够通过长时间的优化运行进行实践、发现问题分解策略并自我纠正,从而产生新兴的多步骤推理。卡帕西将2025年的能力提升归因于计算资源从预训练转移到长时间的RL运行,并引用OpenAI o1→o3的进展作为可感知能力跃升的例子。
大型语言模型的智能分布不均:'幽灵'而非'动物'
卡帕西将大型语言模型的智能描述为‘锯齿状的’——不是进化的生物能力,而是优化产生的行为,他将其比作'召唤的幽灵'。模型在具有可验证奖励的领域(数学、代码)中表现出色,但在琐碎的常识或社交任务上可能同时失败。他认为优化目标与人类进化不同,导致领域的尖峰,使基准不可靠,因为模型可以针对测试套件进行优化。他表示,这种不均匀性解释了在可测任务上的高性能以及对简单提示的意外脆弱性。
大型语言模型应用层的出现;Cursor示范新的软件范式
卡帕西将Cursor描述为一种新的大型语言模型应用层的证明,该层将基础模型组织成垂直化、可生产的系统。他列出了四个应用责任:上下文工程、多模型编排、允许人类干预的特定领域用户界面,以及用户自主性的自主控制滑块。他认为,模型提供者训练通才‘毕业生’,而应用层团队通过数据、传感器、执行和反馈循环将其转化为领域专家。
Claude Code展示的本地代理转变代理部署
卡帕西强调Claude Code作为一个令人信服的示范,展示了一个在用户机器上本地运行的LLM代理。他指出,Claude Code可以调用工具、执行循环推理,并在用户的私有环境和数据中操作。卡帕西主张,本地部署比云容器优先的方法更好地支持开发者协作和上下文使用,他认为如果在这种不均匀模型能力的过渡阶段优先考虑云集成而非本地集成,那将是一个错误的判断。
Vibe编码通过自然语言意图使编程民主化
卡帕西创造并描述了'Vibe编码',即通过自然语言描述意图进行编程,而不关心代码形式。他表示,2025年跨越了一个门槛,使非程序员能够请求并获得可工作的代码,而专业开发者可以廉价生成一次性工具。他提供了使用Vibe编码编写Rust词法分析器和临时工具的示例;他强调代码变得低成本、可丢弃,并改变了软件形态和开发者角色。
大型语言模型图形用户界面出现;Gemini Nano Banana预览视觉优先接口
卡帕西提到谷歌的Gemini Nano Banana是一个被低估的、具有范式信号的产品,它生成与对话相关的图像、信息图、动画和视觉输出。他认为,大型语言模型的交互将从仅文本聊天演变为结合文本、图像、视频和应用程序输出的图形用户界面,这类似于从命令行到图形用户界面的历史转变。他强调文本、图像生成和世界知识在模型权重中的整合是一个关键能力。