
开源人工智能GitHub项目(UniVLA、tensor.h、Claude Code Transcripts)
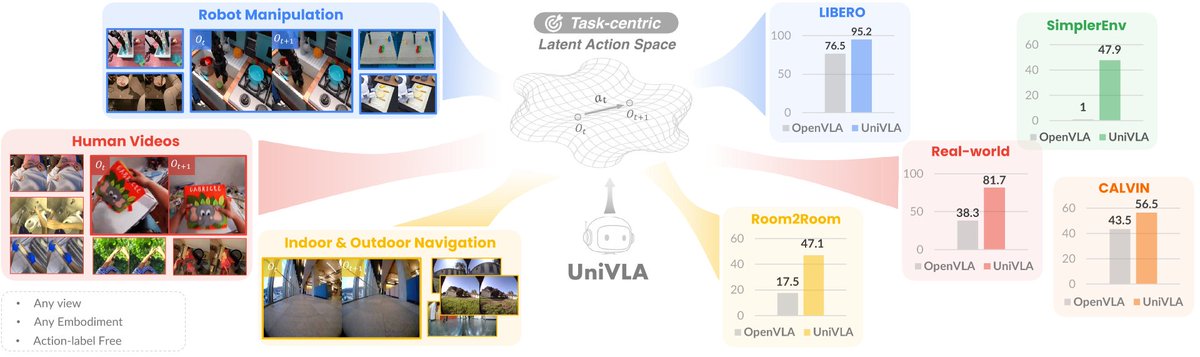
新的GitHub项目发布了推动机器人技术、教育和开发者工作流程的工具。
Key insights
UniVLA提出统一的跨形态机器人策略
UniVLA提出了一种统一的跨形态策略学习方法,该方法提取以任务为中心的潜在动作,使模型学习“该做什么”,而不是硬编码的运动轨迹。该项目统一了动作空间,以允许在跨形态视频数据上进行训练,而不是硬件特定的数据,并提供了预训练模型库以及LoRA支持,以实现高效的微调和部署。该项目在多个基准测试中报告了领先的结果,同时使用了OpenVLA 5%的计算资源,并记录了模型和数据集组合以支持可重复使用。
tensor.h通过纯C张量库教授神经网络
tensor.h是一个教育性的GitHub项目,使用纯C实现了一个最小的张量库,没有任何依赖。该教程解释了张量的创建、形状和步幅机制、前向和反向操作、自动求导实现、损失函数和训练循环,并演示了在MNIST和猫狗分类上的端到端训练。该代码库将代码与数学推导相结合,以展示矩阵乘法、ReLU、LogSoftmax和链式法则梯度计算如何构成神经网络训练的核心。
Claude Code Transcripts将Claude会话转换为可分享的HTML
Claude Code Transcripts是一个Python命令行工具,将Claude Code JSON/JSONL会话文件或网络会话转换为分页的、移动友好的HTML(索引和每页视图)。它支持本地会话目录、网络会话提取(通过逆向工程的Anthropic API)和批量归档;功能包括代码高亮、时间线概览和一键上传到GitHub Gist(通过GitHub CLI)。该工具使用Click、Jinja2、httpx和基于pytest的快照测试,采用Apache 2.0许可证,并从macOS钥匙串中提取令牌以实现自动API访问。
开源工具集强调可重复性和部署
这三个项目强调可重复性和部署:UniVLA提供预训练模型和LoRA准备好的检查点,以便高效适应真实机器人;Claude Code Transcripts生成稳定的HTML档案,配备快照测试和Gist共享,以保留以对话为驱动的开发日志;tensor.h展示了低级实现和推导,以支持神经内部的可重复学习。总体而言,这些代码库记录了数据集和实现细节,以支持模型重用和可重复的训练工作流程。