
微软研究院开源TokenEconomizer插件,降低AI编程智能体成本
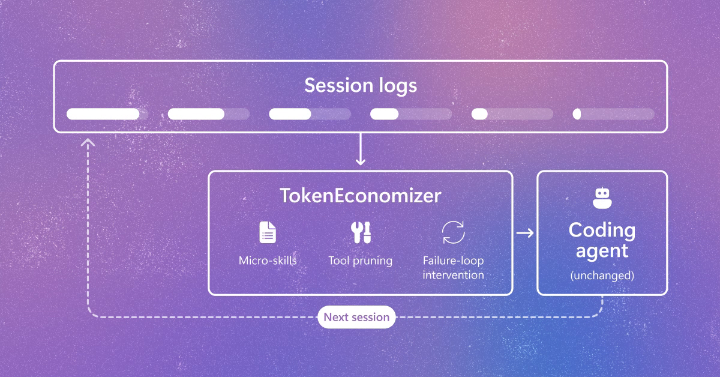
微软研究院、加州大学伯克利分校和微软安全团队发布了TokenEconomizer,这是一款开源插件,可从智能体在代码仓库中的过往会话中学习,在不修改智能体或其模型的情况下减少token浪费。在277个SWE-Bench缺陷修复任务中,该插件在五种智能体-模型组合上将平均成本降低了18.4%至30.9%,全部30个仓库与组合交叉单元的成本均下降,同时Pass@1在五分之四的组合中上升。
事件版本 1.
Key insights
基准测试中的成本节省
在涵盖六个代码仓库和五种智能体-模型组合的277个SWE-Bench任务上,与强默认推理设置相比,TokenEconomizer将平均成本降低了18.4%至30.9%。全部30个仓库与组合交叉单元的成本均下降,Pass@1在五分之四的组合中上升,其中Opus 4.8下降约1.0个百分点。
三种外部控制机制
该插件读取会话日志,并通过现有接口更新仓库状态:将微技能注入起始上下文、精简工具列表,以及在智能体卡住时进行干预。工具精简贡献了最大的节省,其次是微技能和卡住干预。
从零开始的浪费
在60个SWE-Bench任务上对Claude Code进行性能分析显示,当仓库至少有五个任务时,约30%的工具调用重复了先前任务,而跨仓库时这一比例约为7%。每轮加载23个工具描述,其中16个从未被调用,失败任务占任务总数的17%,但约占支出的32%。
节省随经验积累
大多数仓库在最初几个任务上可能成本更高,从第六个任务起累计成本开始变得更低。在Web-Bench上,成本下降约16.0%至21.2%,跨仓库安全审计下降约6.4%至19.6%;当不存在仓库连续性时,微技能被禁用。
提示词token缩减示例
在一个Django示例中,工具精简将首次请求的提示词token从约42,000–46,000降至约15,000–16,000。微技能仅在多个任务确认且更改文件不重叠后才注入,并在出现矛盾证据时永久停用。