
提出分数中心化技术以稳定LLM强化学习
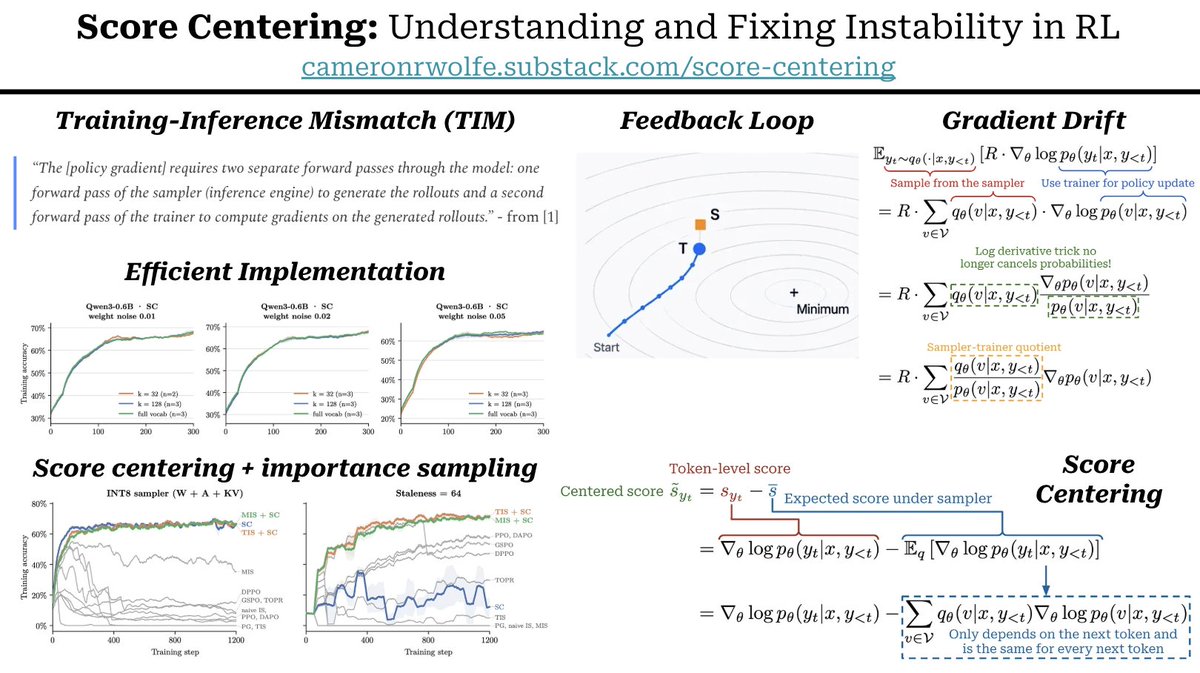
一篇关于分数中心化的深度分析文章解释了为何LLM强化学习在训练-推理不匹配下会变得不稳定,并提出了一种对策略梯度的加性校正方法。该技术从每个采样token的分数中减去采样器的期望token分数,并且可以仅使用采样器的top-k token概率进行近似。作者表明,将分数中心化与截断或掩码重要性采样相结合通常能获得最佳性能。
事件版本 1.
Key insights
训练-推理不匹配导致不稳定性
现代强化学习基础设施将rollout生成和策略更新分离到采样器和训练器引擎中。数值精度、量化、不同的GPU内核以及使用陈旧rollout的异步训练,导致两个引擎之间的token概率存在差异,从而在策略梯度更新中引入系统性偏差。
梯度漂移产生虚假学习信号
在训练-推理不匹配下,恒定奖励设置会产生非零的期望策略梯度,这是一种称为梯度漂移的虚假学习信号。这种漂移会将训练器推向采样器,而不考虑奖励信号。
反馈循环累积误差
在线强化学习从训练器刷新采样器,形成反馈循环。对训练器的有偏更新会传播到采样器,并且随着循环重复,误差会累积。
分数中心化以加性方式校正漂移
分数中心化从每个采样token的分数中减去采样器下的期望分数。中心化后的分数在每个前缀处具有零期望,从而消除漂移。
高效近似与重要性采样结合
该校正可以仅使用采样器的top-k token概率进行近似,其中k等于32或128,剩余概率质量由训练器的分布近似。最佳性能通常通过将分数中心化与截断或掩码重要性采样相结合来实现,这有助于处理极端不匹配情况,例如非常陈旧的rollout。