
机器人AI后训练标准化亟待推进
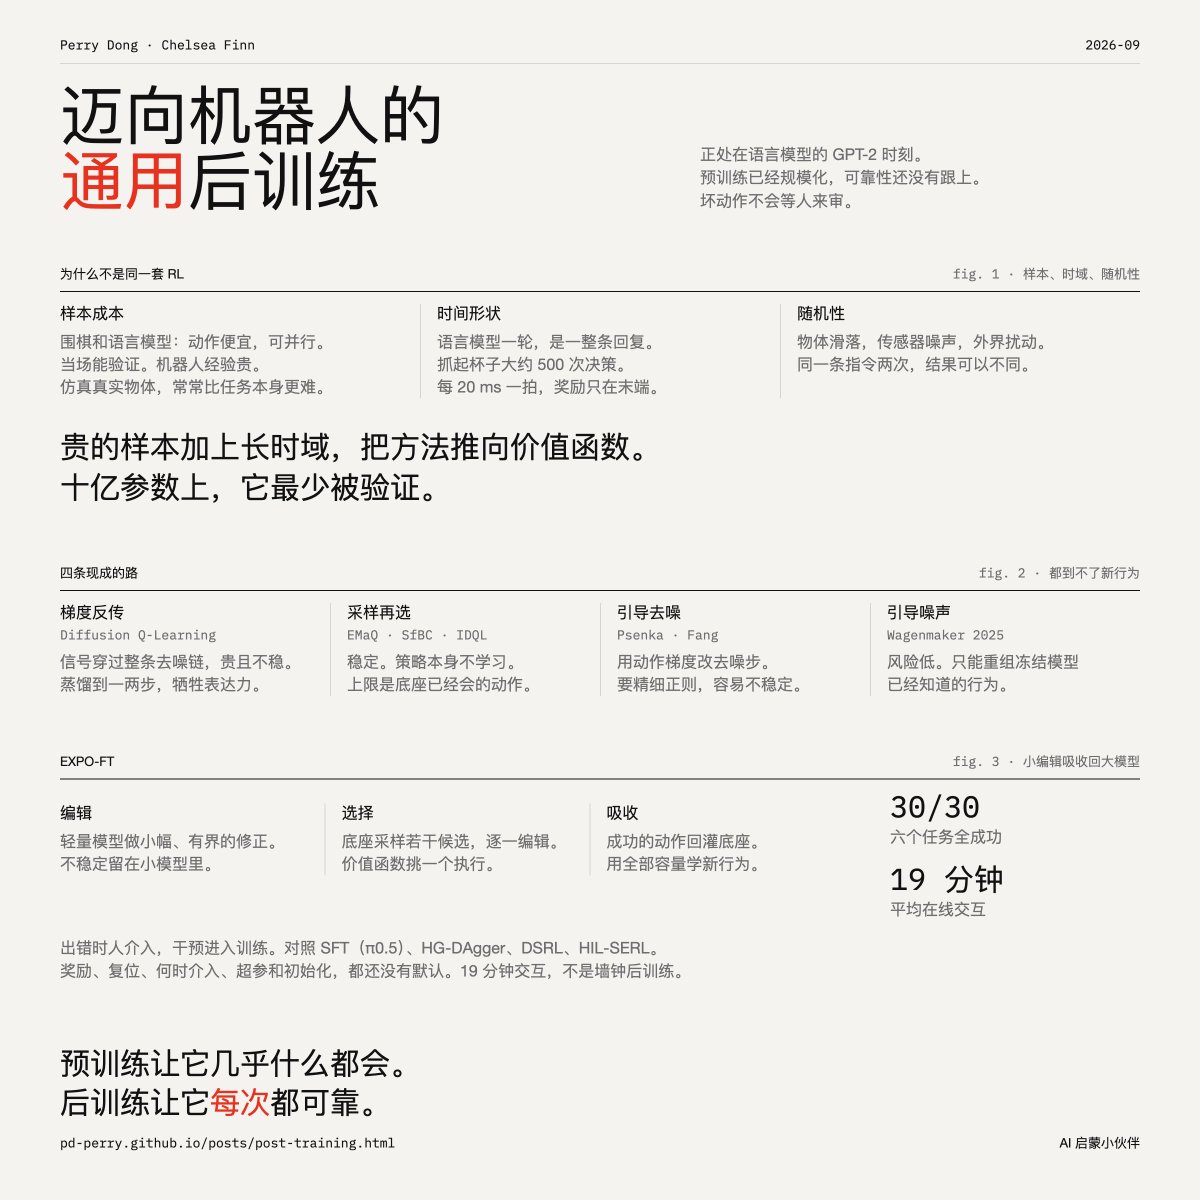
研究人员指出,机器人AI正处于‘GPT-2时刻’,预训练规模扩大但缺乏标准化的后训练以确保可靠性。他们提出EXPO-FT方法,将小型编辑策略与基于价值的强化学习相结合,在仅19分钟的在线交互中,于六项复杂操作任务上取得了完美成功。
Key insights
机器人AI处于‘GPT-2时刻’
机器人AI领域已扩展了预训练(VLA、世界-动作模型),提供了广泛但不可靠的能力。缺失的是一个标准化、可复用的后训练流程,类似于LLM的监督微调、RLHF和RLVR。作者认为,机器人领域需要更严格的可靠性,因为错误动作会立即发生,没有人工审查。
机器人RL与LLM RL的独特挑战
机器人强化学习存在根本差异:样本成本高(真实机器人经验昂贵),时间跨度涉及每项任务数百个低级决策且奖励稀疏,物理和传感器的随机性使信用分配复杂化。这些因素促使机器人领域转向基于价值的强化学习,而后者在十亿参数规模上验证最少。
EXPO-FT:一种候选解决方案
EXPO-FT采用三阶段机制:轻量级编辑策略对基础模型输出进行有界修正,价值函数选择最佳动作,成功动作被吸收回基础模型进行学习。这在不稳定性限制在小模型的同时,利用了大型模型的能力。当出现错误时,使用人工监督进行干预。
实验结果:复杂任务上的完美成功
EXPO-FT在六项复杂操作任务(如穿钩、击球入袋、翻蛋)上实现了30/30的成功率,平均仅需19分钟在线交互。其表现显著优于π0.5上的SFT、HG-DAgger、DSRL和HIL-SERL等基线方法,后者平均成功次数为5.5至20.5。
标准化面临的协议问题
作者指出了几个需要社区达成共识的协议问题:如何指定奖励(尚无RLVR等效方法)、由谁执行重置、需要多少人工反馈以及默认超参数。他们已发布EXPO-FT调优参考,作为迈向标准化流程的一步。
现有方法失败的原因
论文提供了‘排除地图’:扩散Q学习昂贵且不稳定;先采样后选择的方法从未改进策略;动作梯度引导需要精细正则化;输入噪声空间引导仅重组已知行为。经典的基于价值的强化学习假设单峰高斯策略,而前沿模型使用多模态扩散/流生成。