
生产AI的检索、RAG和记忆基础设施
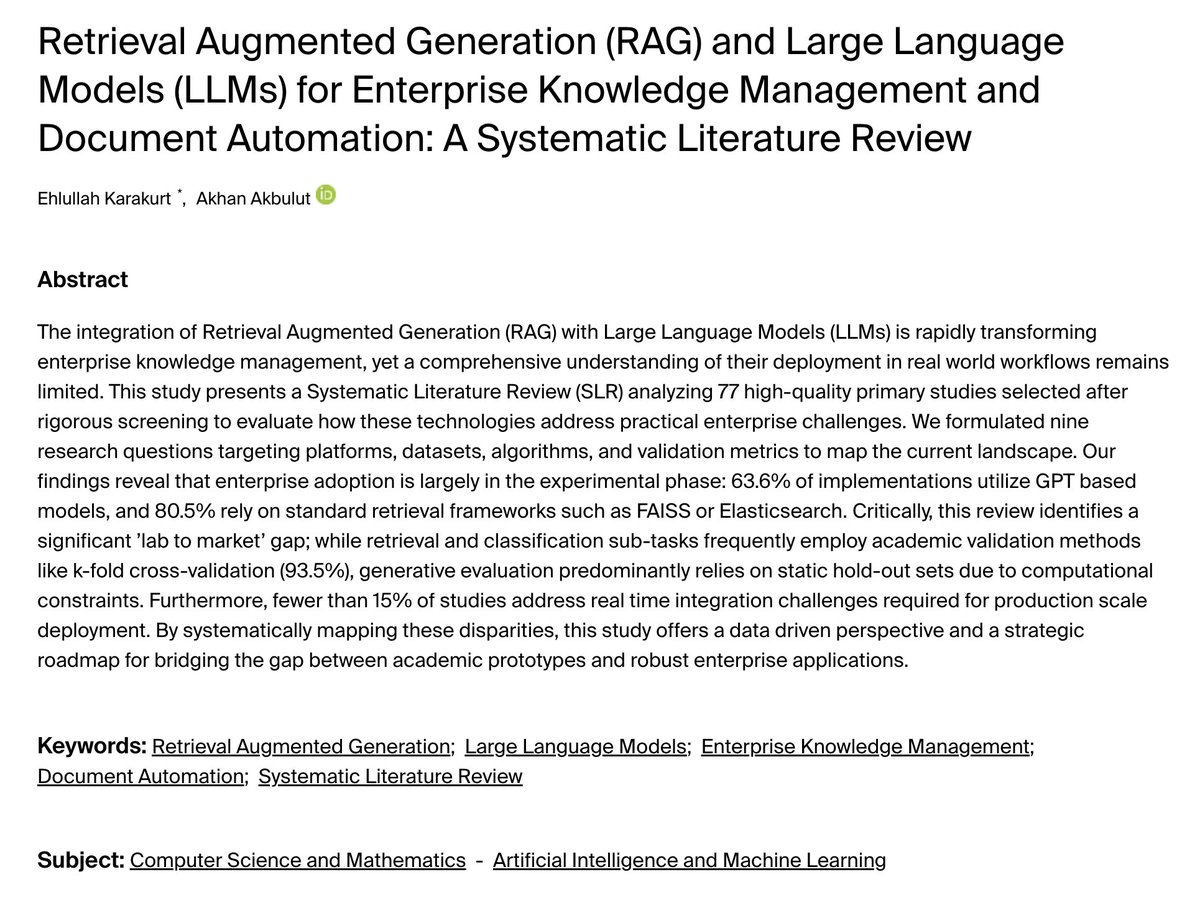
检索、RAG和记忆系统显示出生产差距和新的工程模式。- 对77项RAG研究的系统评审发现63.6%使用GPT模型,80.5%使用FAISS/Elastic - 仅有13%的RAG研究达到了企业部署;主要挑战包括幻觉、隐私、延迟和领域适应 - 混合检索(向量+知识图谱)在一些研究中提高了可解释性和准确性 - 来自OpenRouter/a16z的行业数据表明,代理性、多步骤的使用和中型开放模型正在获得市场份额 - Index是一个优化了代理精度的生产搜索系统:Postgres + pgvector、边缘工作者、三层缓存 - Index实现了低于300毫秒的P99,并支持动态、多租户过滤,具有高效的摄取/更新 - Anthropic的高级工具使用引入了工具搜索、编程调用和示例,以减少令牌膨胀并提高准确性。
Key insights
RAG研究的企业部署有限且面临重复的运营挑战
对77项RAG研究的文献回顾显示,大多数原型依赖于GPT风格模型和已建立的检索库(FAISS/Elasticsearch),但仅有13%推进到了企业部署。反复出现的障碍包括幻觉控制、数据隐私、延迟和领域适应;许多研究中商业影响仍然难以量化。
混合检索提高事实性和可解释性
研究报告显示,将密集向量检索与结构化知识图谱或元数据相结合,提高了精度和来源,提升了可解释性并减少了在企业环境中纯向量检索的幻觉风险。
Index展示了用于代理用例的生产搜索架构
Index为毫秒级代理检索而构建,使用Postgres(pgvector + pg_trgm + tsvector)、Cloudflare Workers全球边缘运行时、三层缓存系统和块级摄取,以保持低于300毫秒的P99延迟和准确的混合检索。该设计强调动态过滤、多租户隔离和增量嵌入更新,以避免重新处理。
高级工具使用模式减少令牌成本并扩展工具目录
Anthropic的高级工具使用——通过工具搜索元工具延迟工具加载、编程(代码)编排多工具序列和明确的使用示例——减少了令牌消耗,并在代理必须访问数百或数千个工具时提高了工具选择的准确性。
OpenRouter数据表明代理工作流和中型模型上升
OpenRouter和a16z对真实交互数据的分析表明,代理性多步骤推理显著增长,而'中型'开放模型(15B–70B)因其成本效益的开发者工作流而获得了采用,同时工具调用和更长的提示增加了平均用户提示长度。