
网络爬虫与自动化解决方案
提取文章内容和自动化动态网络爬虫的工具和方法。
Key insights
文章提取器用于清晰的文章提取
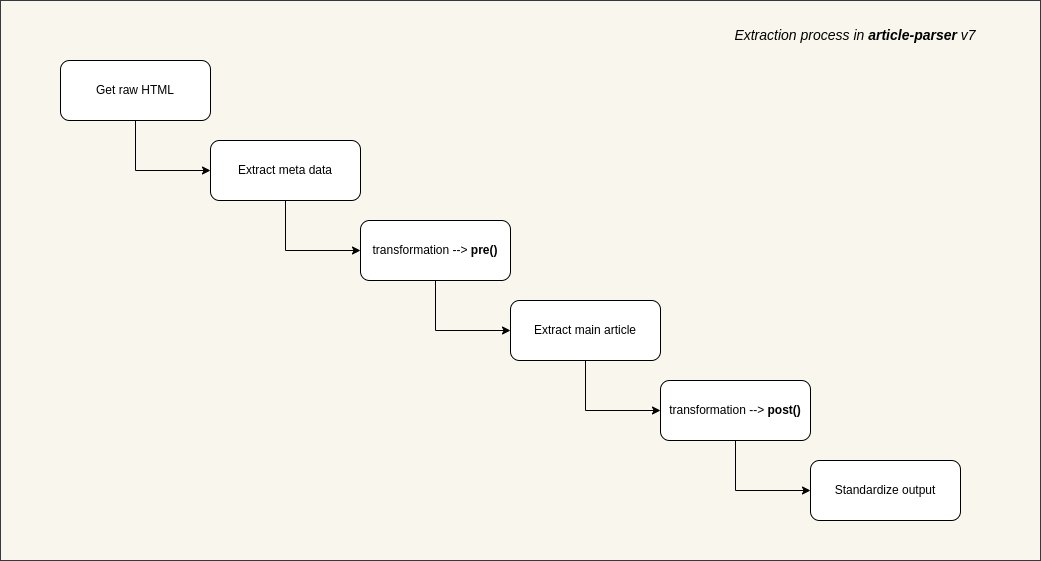
一篇文章强调了开源的文章提取器库,旨在从杂乱的网页中提取核心文章数据,去除广告、侧边栏和导航。该库返回结构化字段,如标题、正文、封面图像、作者和阅读时间,支持每个域的自定义转换,并与Node.js、Bun和浏览器兼容,具备代理和头部配置以应对反爬虫策略。
Doubao通过设备控制实现动态移动网络爬虫自动化
一篇转发的笔记报告称,Doubao通过控制Android设备解决了小红书和抖音的动态加载问题:模拟滑动、对屏幕截图进行OCR以提取封面文本,并自动化交互流程。该文章将Doubao的方法与之前的工具(comet、dia、manus)进行了对比,后者在这些动态加载页面上未能成功。
聚合商业模式应对反机器人障碍
一篇文章观察到,简单的聚合和分发仍然是可行的策略;它举了一个例子,运营商将验证码挑战路由到后端,并将任务外包给人类工人,展示了应对爬虫和自动化挑战的务实解决方案。