
聊天机器人中的上下文、记忆与长上下文策略
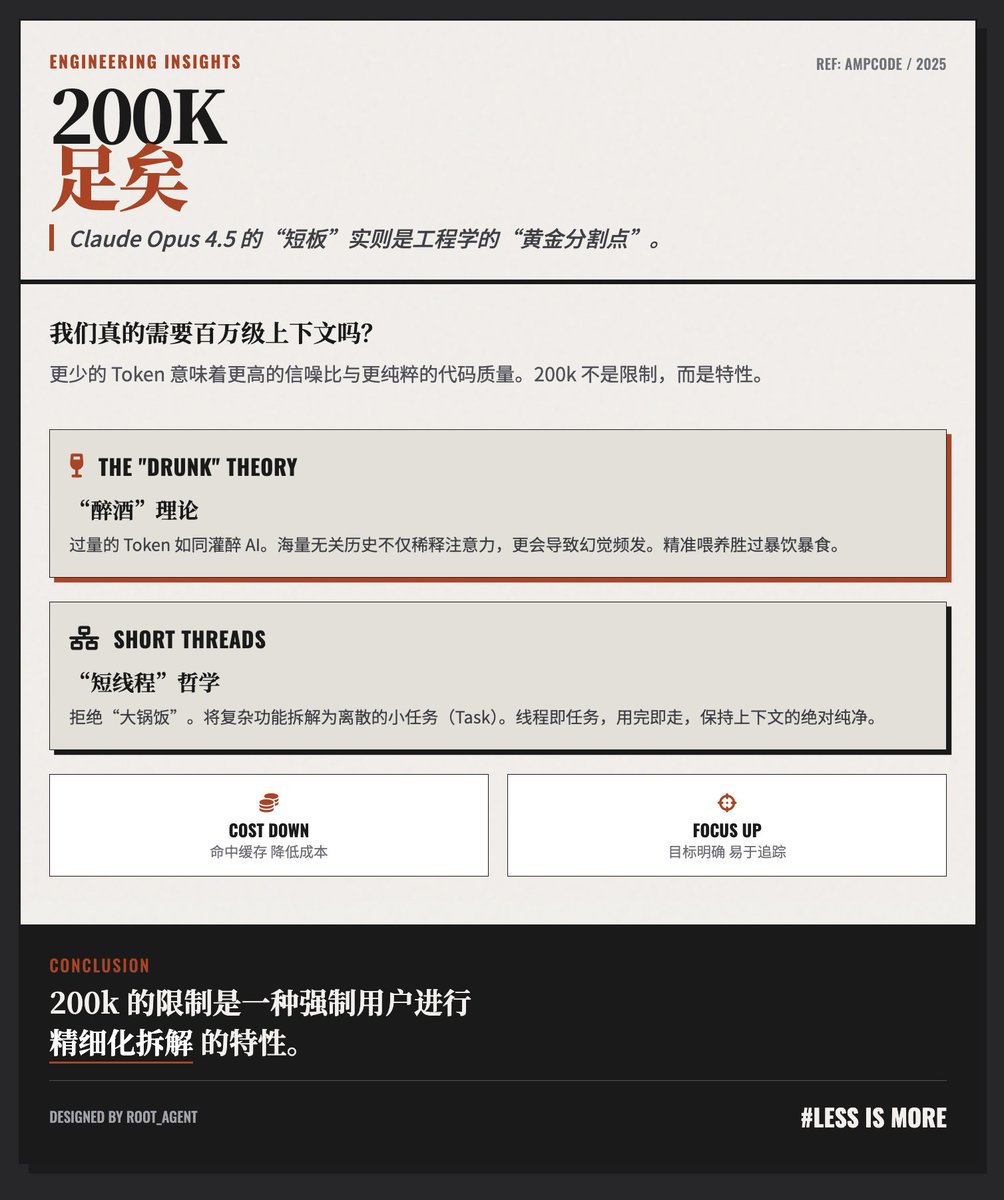
关于聊天模型的最佳上下文窗口和记忆架构的辩论。- AmpCode认为200k个标记是足够的,且通常更可取;过多的上下文会降低信噪比,并导致“醉酒”代理行为。- 建议:将复杂任务分解为短小的互相关联的线程;在线程之间传递上下文,而不是积累长久的历史。- ChatGPT的记忆方法:每个会话完全注入用户事实和预先计算的轻量级近期对话摘要(10-15个会话),以及会话元数据;系统在每个会话中将这些注入提示中。- Claude的记忆方法:通过工具按需检索(conversation_search,recent_chats);默认情况下不加载历史,除非模型/工具调用检索。- ChatGPT的优点:无缝的连续性和速度;缺点:粗略的摘要和可能的无关干扰。Claude的优点:精确检索和更清晰的上下文;缺点:速度较慢,可能不够主动。- 实用的提示模式:“连接搜索 + 综合”(互联网搜索,然后概述/摘要)在几分钟内产生更好的、接近深度研究的结果;建议将输出存储为结构化的个人笔记。
Key insights
短线程工作流程和200k标记窗口可以带来更好的结果
一篇工程博客认为,过长的上下文窗口(超过200k标记)可能会通过降低信噪比来损害模型性能;200k标记通常是足够的。推荐的工作流程是将大型任务分解为多个短线程,每个线程都有明确的目标,并在线程之间传递必要的上下文,而不是保留不断增长的对话历史。
ChatGPT使用预计算注入和轻量摘要来保持连续性
ChatGPT的记忆系统在每个会话中将会话元数据、明确的用户记忆(可编辑)和最近10-15个用户对话的预计算轻量摘要注入提示中。该设计通过为模型提供紧凑的近期历史图谱,促进了连续性和速度。
Claude使用按需检索工具以实现高保真记忆访问
Claude的方法默认不包括先前的对话;相反,它有专门的检索工具(conversation_search,recent_chats),模型可以在确定需要历史上下文时调用。这种方法提供了更高保真的过去细节回忆,但需要模型选择调用搜索,并且可能较慢。
'互联网搜索 + 摘要'是一种高产出的提示模式
一种紧凑的提示例程——明确要求模型执行互联网搜索并生成综合/概述——在几分钟内提供接近'深度研究'的结果。建议用户将这些摘要输出存储为结构化笔记(例如,在Logseq中),以构建个人知识积木。