
腾讯WeKnora与T-Mem:企业知识平台与记忆系统
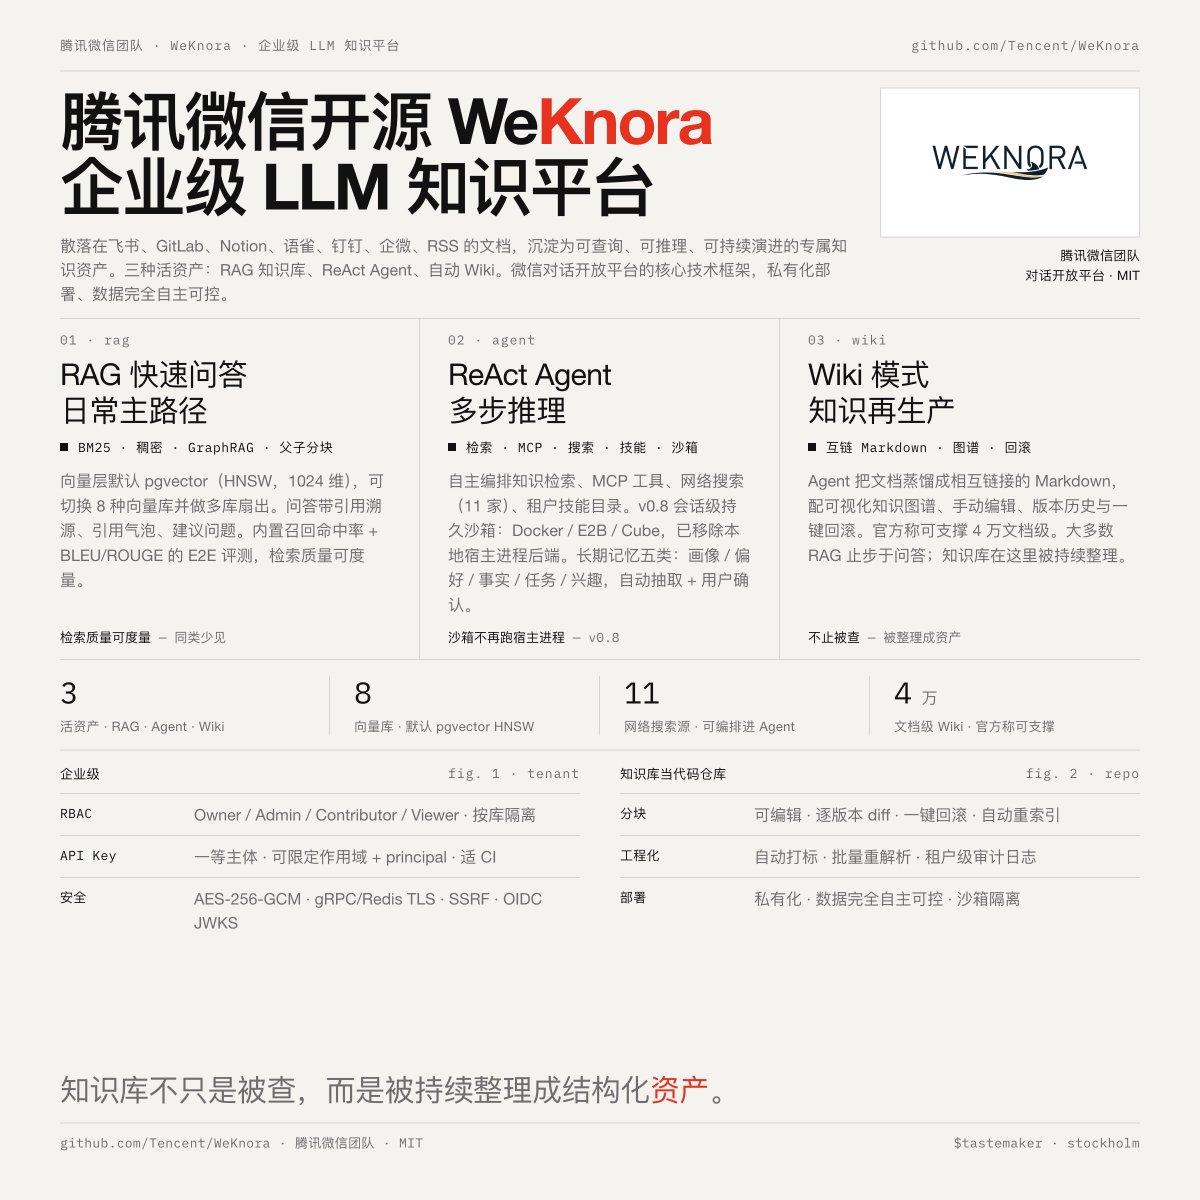
腾讯开源了WeKnora,这是一个企业级LLM知识平台,可将文档转换为RAG知识库、ReAct代理和自动生成的维基。另外,腾讯发布了T-Mem,这是一个引入“触发器”进行联想回忆的记忆系统,解决了无词汇重叠记忆检索的问题。T-Mem在LoCoMo上达到80.26%的准确率,优于基线。
Key insights
WeKnora:企业知识平台
WeKnora从各种来源(飞书、GitLab、Notion等)摄取文档,并生成三种资产:用于问答的RAG知识库、用于复杂推理的ReAct代理,以及自动生成的维基。它支持BM25、稠密向量、GraphRAG和多策略检索。功能包括基于RBAC的多租户、API密钥管理、AES-256-GCM加密和沙箱隔离。维基模式自动将文档提炼为带版本历史的关联Markdown。
T-Mem:带触发器的联想记忆
T-Mem解决了现有仅依赖相似性搜索的记忆系统的局限性。它在写入记忆时生成“触发器”,以预测记忆在未来可能相关的上下文。四个触发器族覆盖了设计空间:实体(事实性)、桥接(联想事实到场景)、场景(描述性)和地平线(联想场景到未来)。这使得即使在查询和记忆之间没有任何词汇重叠时也能实现回忆。
T-Mem性能:在联想回忆上优于基线
在LoCoMo上,T-Mem实现了80.26%的准确率,比HyperMem高出3.25个百分点。在LoCoMo-Plus的Cognitive子集(用于测试纯联想回忆)上,T-Mem得分74.81%,远超HyperMem(48.63%)和GPT-4o零样本(21.05%)。消融研究表明,移除联想触发器会导致LoCoMo-Plus上22.19个百分点的下降,而描述性组件的影响很小。这证实了基于相似性检索的结构性盲点。
T-Mem架构:TypeGraph与离线流水线
记忆被组织为带有五种对象类型的类型化图:场景(对话片段)、条目(原子事实)、主题(仅用于过滤)、触发器(仅用于检索)和人物角色。构建流水线按事件闭合进行分段,按主题分组,提取条目,并生成触发器。检索是一个三级级联(主题→场景→条目),并采用RRF融合。触发器绕过主题预过滤以避免相似性偏差。该系统在CPU上运行,无需GPU。