英伟达:注意力机制架构设定长上下文模型服务速度上限
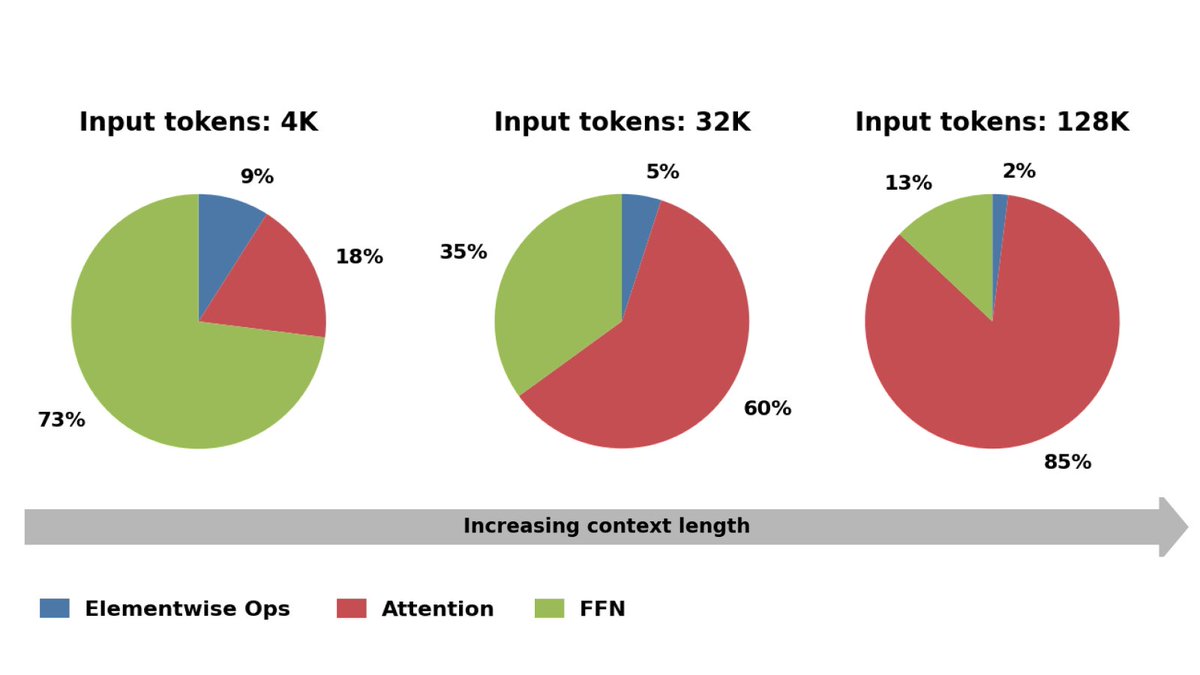
长上下文模型的服务速度在很大程度上在训练开始前就已确定。虽然注意力机制过去仅占推理成本的一小部分,但随着上下文窗口的扩展,其占比急剧增加。一旦注意力机制占据主导地位,更快的核心算法便不足以应对,注意力机制的架构便设定了性能上限。英伟达的AI模型协同设计系列探讨了决定这一上限的四种架构选择:分组大小、头维度、KV缓存大小和并行策略。该文章解释了正确的选择如何同时提升系统吞吐量和单用户响应速度。

长上下文模型的服务速度在很大程度上在训练开始前就已确定。虽然注意力机制过去仅占推理成本的一小部分,但随着上下文窗口的扩展,其占比急剧增加。一旦注意力机制占据主导地位,更快的核心算法便不足以应对,注意力机制的架构便设定了性能上限。英伟达的AI模型协同设计系列探讨了决定这一上限的四种架构选择:分组大小、头维度、KV缓存大小和并行策略。该文章解释了正确的选择如何同时提升系统吞吐量和单用户响应速度。