
萨顿与强化学习:对 LLM 路径的批判与强化学习论述
理查德·萨顿提出 LLM 路线的局限,主张以强化学习为基础的智能体路径。
Key insights
萨顿:LLM 无外部目标,非基础 AI 路线
理查德·萨顿指出,大型语言模型的训练目标是预测下一个词(token),因此缺乏明确的外部目标与执行行动来影响环境,不能像强化学习主体那样通过试错在真实世界中持续学习。他引用 McCarthy 对“智能”的定义,强调目标与奖励信号在构建真正智能体中的核心地位。
强化学习是构建可持续学习主体的路径
萨顿强调强化学习的主体—行动—观察—调整循环可以在真实环境中持续改进,并以 TD-Gammon、AlphaZero、MuZero 等实例说明经验驱动方法能产生超越模仿的性能,这些方法体现了以目标导向与经验学习为核心的可扩展性优势。
从动物学习中寻找智能基础的建议
萨顿提出理解动物(如松鼠)的学习机制对理解人类智能具有重要参考价值,指出自然界的试错与奖励机制是通用学习能力的基础,而现行的 LLM 方法更多是模仿而非基于经验的探索学习。
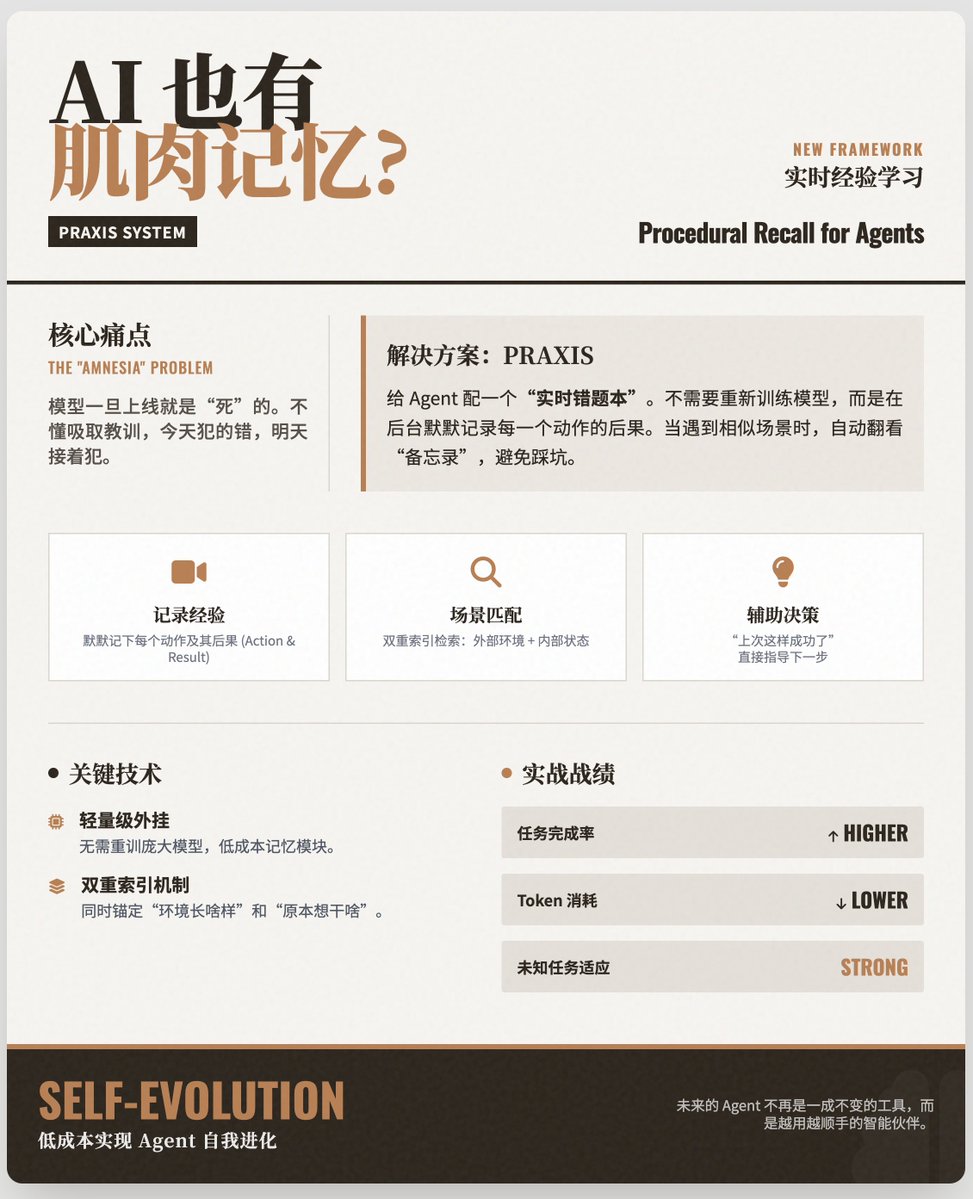
PRAXIS:让 Agent 在部署后实现可检索的“肌肉记忆”
为解决部署后 Agent 无法学习的问题,PRAXIS 提出一个实时经验记录与检索机制,记录 Agent 的动作与后果,双重索引外部场景与内部状态,当遇到相似情形时检索并辅助决策,实验显示在网页浏览任务上显著提升完成率并降低成本。