
训练与算力竞争:TPUv7 与训练基础设施风险
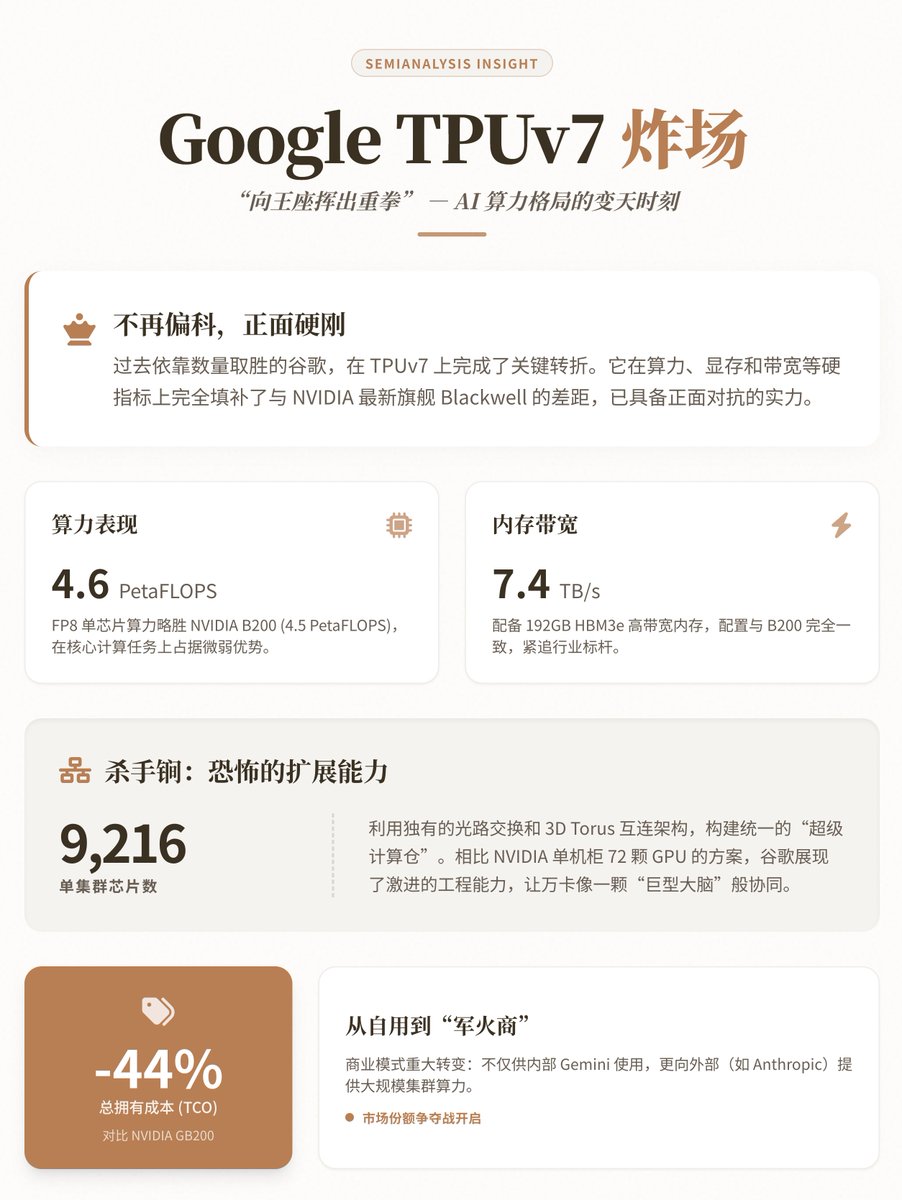
分析指出 TPUv7(Ironwood)在单芯片算力、内存与带宽上接近或追平 NVIDIA Blackwell,并在大规模互联与拥有成本上具备优势;同时有研究者警示训练基础设施为风险中心。
Key insights
TPUv7 在单芯片与内存规格上追平或超过 Blackwell
分析指出 TPUv7 的 FP8 算力约 4.6 PFLOPS,配备 192GB HBM3e 与约 7.4 TB/s 内存带宽,单芯片性能指标与 NVIDIA Blackwell(B200)处于同一量级,表明谷歌在硬件设计上实现了重要突破。
TPUv7 的扩展互联与集群规模是差异化优势
谷歌通过光路交换与 3D Torus 互连架构可把数千至 9,216 颗 TPUv7 连接成统一超大集群,这种大规模低延迟互连在训练超大模型时能显著降低通信瓶颈,是其相对竞争优势的关键。
TPUv7 在总拥有成本上具备显著竞争力
分析估算称谷歌垂直整合的 TPUv7 方案在总拥有成本上比部署 NVIDIA GB200 服务器方案低约 44%,这对需要大规模训练算力的机构具有经济吸引力。
训练基础设施是资本与风险集中区,应用层被相对低估
吴恩达提出将 AI 拆成应用、推理与训练三层:应用层目前被低估且长期价值被忽视;推理层存在供给紧张;训练层是资本密集且风险最大的领域,开源模型与硬件进展可能削弱单一厂商的护城河。