
记忆、上下文管理与智能体技能(Claude / ChatGPT)
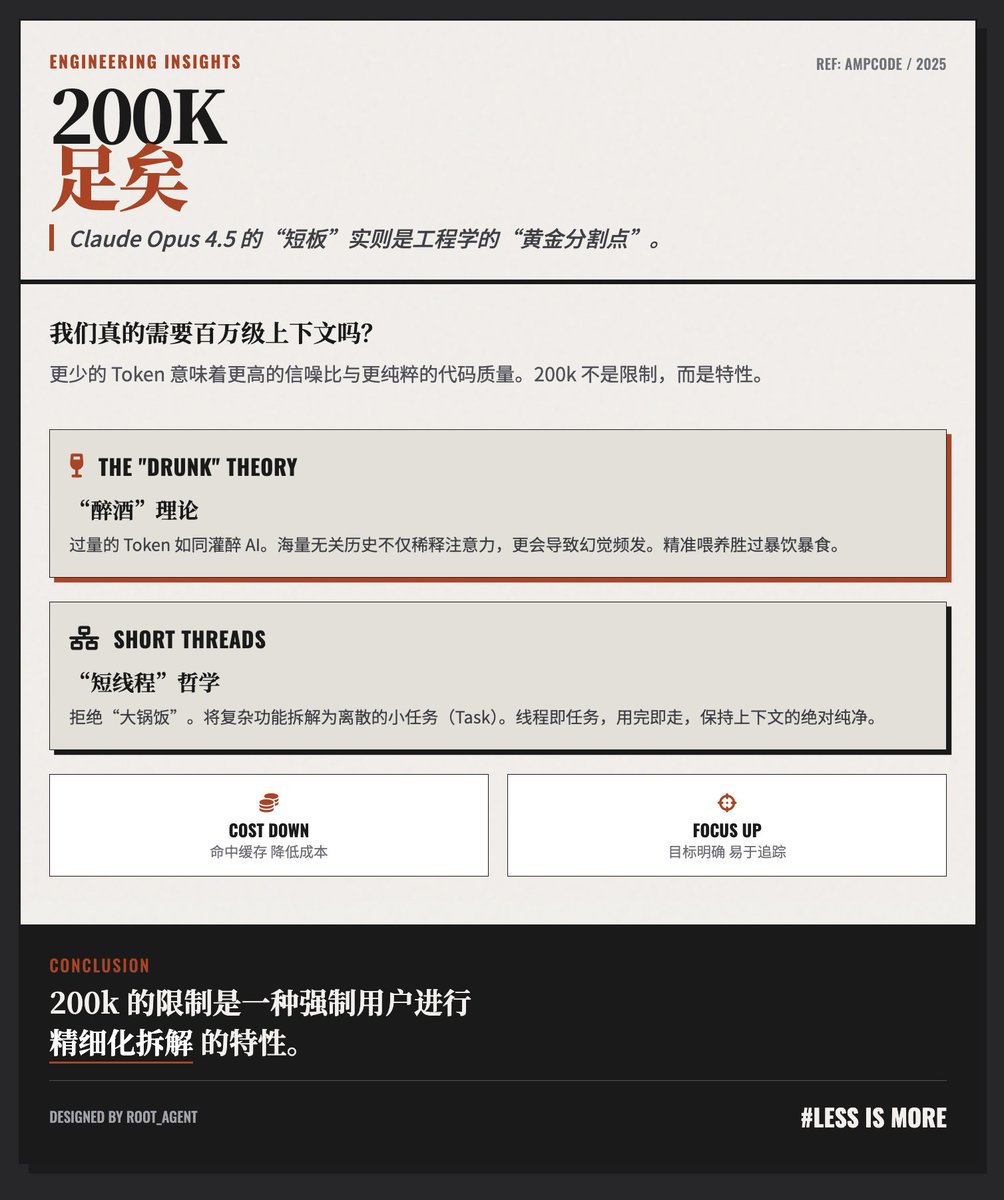
多项分析比较了现代大型语言模型(LLMs)的记忆架构、智能体技能和上下文策略。- 一篇论文认为20万标记足够;建议采用“短线程”任务分解以避免上下文噪声(20万标记足以应对高质量编码任务)。- ChatGPT的记忆设计被描述为四层结构:会话元数据、用户记忆(长期事实)、最近对话摘要(约10-15个会话)和当前会话窗口。- Claude的记忆设计使用按需检索工具(conversation_search、recent_chats),默认情况下避免注入完整历史。- Claude-Mem开源项目为Claude Code提供本地、压缩的持久记忆,采用语义压缩和SQLite,节省标记成本并实现跨会话连续性。- ChatGPT在思维模型中引入了内置智能体技能,初始支持三项技能(excel、word、pdf),并支持压缩本地技能文件进行处理。- 实际权衡指出:ChatGPT通过注入技术偏向无缝用户体验;Claude通过检索工具偏向精确性。
Key insights
20万标记上下文被认为足够且更适合编码工作流
一篇技术文章认为20万标记的上下文窗口对于高质量编码和任务执行并不是限制;该文章建议将复杂项目拆分为多个简洁的“线程”,每个线程仅包含必要的上下文。该论点引用了巨型连续历史的信号与噪声问题、标记成本、缓存效率低下和操作可管理性,并认为更短的线程工作流提高了可靠性和成本效率。
ChatGPT使用四层记忆注入架构
反向工程工作将ChatGPT的记忆描述为四层结构:会话元数据(临时环境信号)、用户记忆(存储和注入的长期事实)、最近对话摘要(约10-15个先前会话的轻量级摘要)和当前会话窗口。这一设计强调预计算摘要加上显式的长期事实,以平衡个性化、标记成本和响应能力。
Claude依赖按需检索工具以精确访问过去的上下文
Claude的记忆方法被描述为以检索为先的设计:它默认不注入过去的对话,而是提供工具(conversation_search、recent_chats),当模型判断需要历史上下文时调用这些工具。这使得高保真地检索过去的细节成为可能,但增加了延迟,并要求模型判断何时调用工具。
开源和第三方项目增加持久压缩记忆和技能
像Claude-Mem这样的项目为Claude Code提供本地、压缩的持久记忆,利用语义压缩和SQLite存储恢复跨会话上下文,同时减少标记使用。此外,ChatGPT的思维模型开始推出智能体技能(excel、word、pdf),并支持读取压缩的本地技能文件;开源工具和智能体技能管理器正在出现,以将技能逻辑卸载到模型上下文窗口之外。