
谷歌 TPUv7 对标 NVIDIA Blackwell 的深度分析
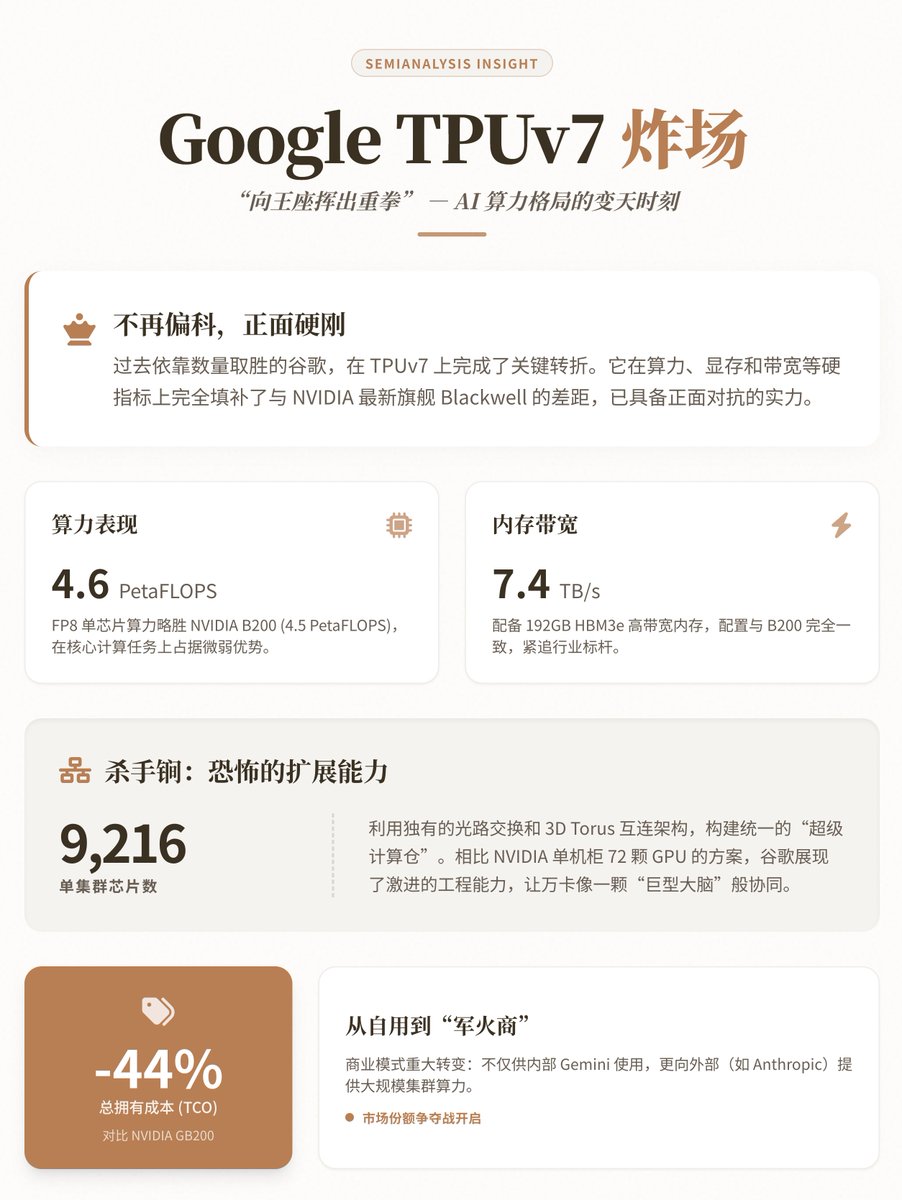
谷歌 TPUv7(代号 Ironwood)在性能、内存与互连上追平或超越 NVIDIA Blackwell(B200),并具备显著扩展与成本优势。
Key insights
TPUv7 单芯片算力追平或略超 Blackwell
报告列出 TPUv7 单芯片 FP8 算力约 4.6 PetaFLOPS,略高于 NVIDIA B200 的 4.5 PetaFLOPS;TPUv7 配备 192GB HBM3e,带宽达到 7.4 TB/s,规格与 B200 基本同级。文中对比了关键硬件参数并指出在常用训练与推理计算上 TPUv7 在硬指标上已与 Blackwell 处于同一量级。
TPUv7 的扩展互联是核心竞争力
文章指出 TPUv7 的最大优势在于扩展能力:谷歌通过光路交换技术与 3D Torus 互连,可将最多 9,216 颗 TPUv7 芯片连成单一超级集群,从而在训练万亿参数模型时显著降低通信瓶颈;对比显示 NVIDIA 常见的 GB200 NVL72 系统是单机 72 GPU,尽管可跨机柜扩展但在单一大规模集群构建上与谷歌不同。
谷歌的垂直整合带来显著 TCO 优势
SemiAnalysis 估算称,由于谷歌掌控芯片设计、数据中心、散热和网络等端到端能力,TPUv7 系统的总拥有成本相比购买 NVIDIA GB200 服务器方案低约 44%,对需要大规模算力的客户具有价格吸引力,并可能改变采购选择。
谷歌商业模式由内部自用向外部销售转变
文章指出 TPU 过去主要供谷歌内部使用,外部客户通过云租用;现在谷歌向外部提供更灵活的算力服务,并吸引了像 Anthropic 这样的客户,Anthropic 承诺购买并使用大规模 TPU 集群,显示谷歌开始以“算力供应商”身份在市场与 NVIDIA 竞争。
CUDA 护城河被工程能力与开源生态挑战的看法
另一篇用户评论指出,英伟达的 CUDA 护城河并不牢固,优秀工程师可以通过软件(如 Triton)和系统调优超越现有实现;历史上许多模型并非只能在 GPU 上训练,Anthropic 与其他厂商长期使用 TPU,硬件效率差异有限,关键在于 kernel 与系统工程人才。