谷歌Android Bench 2.0显示AI代理在真实Android任务中表现不佳
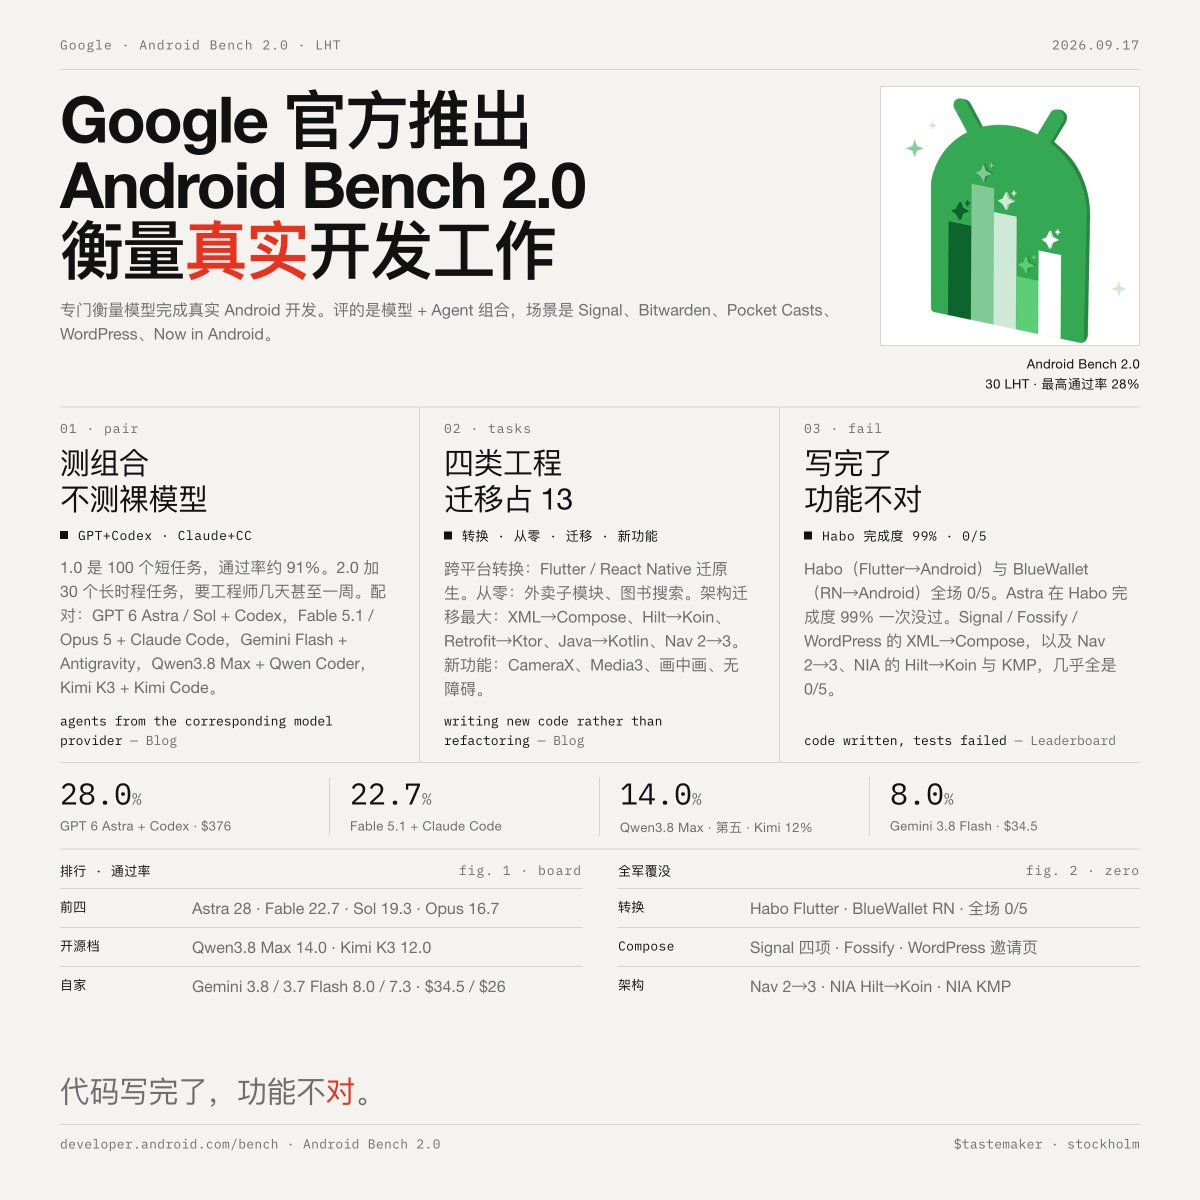
谷歌发布了Android Bench 2.0,这是一个衡量AI模型在执行真实Android开发任务时能力的基准测试,使用了Signal和Bitwarden等生产级应用。最佳模型与代理组合的通过率仅为28%,GPT-6 Astra + Codex和Claude Fable 5.1 + Claude Code组合领先。所有模型在跨平台转换任务和多项XML-to-Compose迁移中均得分为0/5。

谷歌发布了Android Bench 2.0,这是一个衡量AI模型在执行真实Android开发任务时能力的基准测试,使用了Signal和Bitwarden等生产级应用。最佳模型与代理组合的通过率仅为28%,GPT-6 Astra + Codex和Claude Fable 5.1 + Claude Code组合领先。所有模型在跨平台转换任务和多项XML-to-Compose迁移中均得分为0/5。