
谷歌Gemini Live API和原生音频模型更新
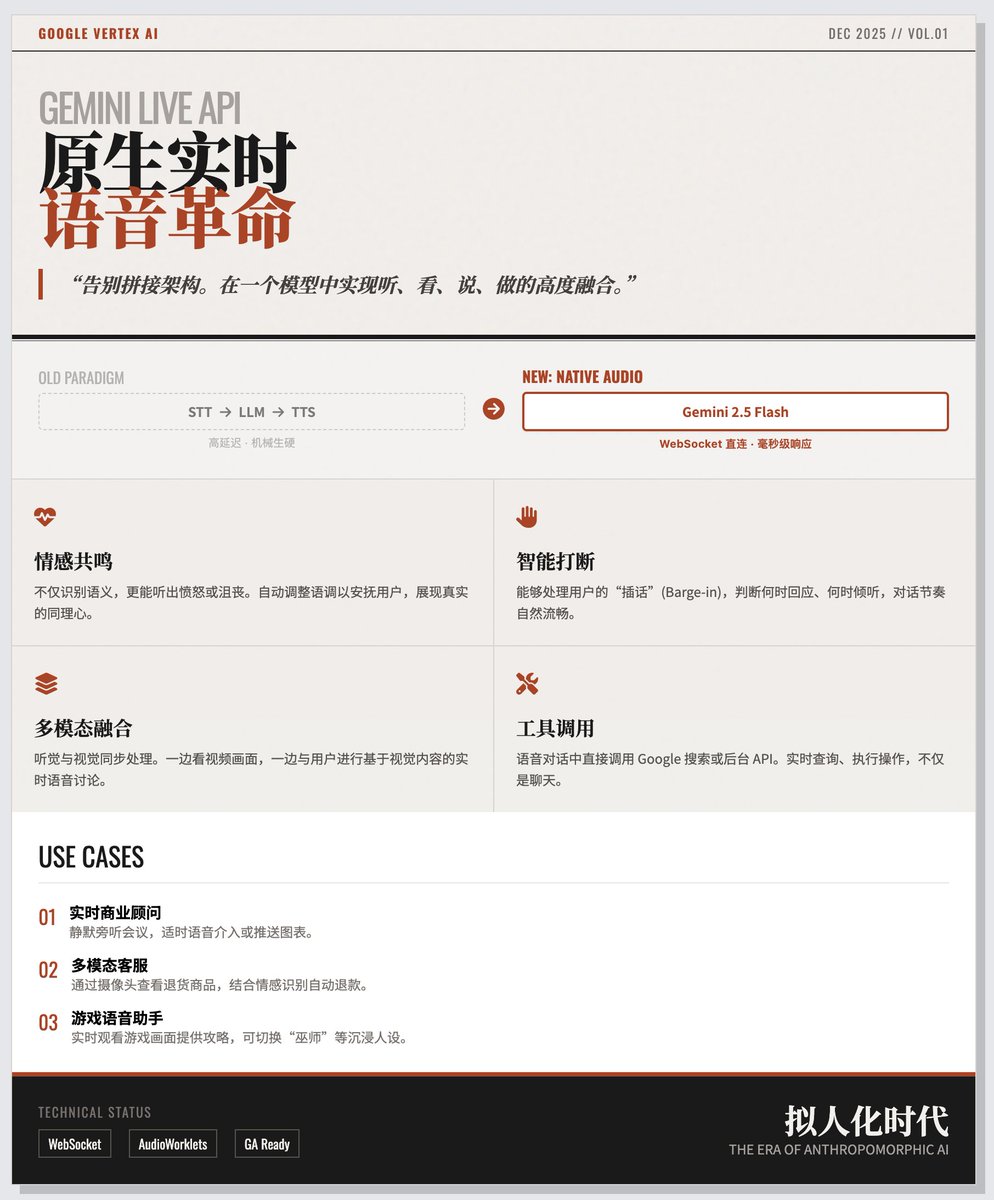
谷歌推出了具有原生音频功能的Gemini Live API。
Key insights
Gemini Live API提供原生实时音频多模态处理
谷歌宣布Gemini Live API作为GA版本推出,基于Gemini 2.5 Flash原生音频模型。该API实现了单模型方法,直接处理原始音频并生成音频响应,消除了之前的STT→LLM→TTS流程。该服务在统一工作流程中接受音频、视频、文本和视觉输入,并通过单个WebSocket连接提供毫秒级延迟,以实现实时交互。这些事实在Live API的发布文档和演示描述中有所说明。
API强调类人对话行为和企业稳定性
Gemini Live API文档强调了五个核心类人能力:检测说话者的情感、语调和语速;自适应语音调节以安抚或表达同理心;智能中断和插入处理以保持自然对话节奏;在语音交互中调用外部工具和谷歌搜索的能力;以及跨多模态会话的持久记忆。该发布作为GA提供,具有企业级高可用性和多区域支持,表明其已准备好投入生产。
开发者模板和演示展示集成模式
谷歌发布了两个快速入门模板(一个无依赖的Vanilla JS模板,演示WebSocket和媒体流,以及一个具有音频工作流组件的模块化React模板)和三个代表性演示。这些演示包括一个具有静音和发言模式的实时商业顾问,可以推送图表或通过语音干预;一个多模态客户服务流程,利用摄像头输入和语音情感检测调用后端工具(例如退款);以及一个游戏语音助手,监控游戏玩法并让用户为不同的游戏角色切换AI角色。
原生音频模型更新以支持功能调用和实时指令跟随
另外,谷歌宣布更新的Gemini原生音频模型已向开发者推出,具备更高精度的功能调用、改进的实时指令跟随能力以及更流畅、更连贯的对话能力。该更新被描述为立即可供开发者在Gemini API中使用,并补充了Live API的原生音频功能。更新信息在Live API博客时间戳前一天发布。