
谷歌Gemini生态系统:实时API、代理和多模态特性
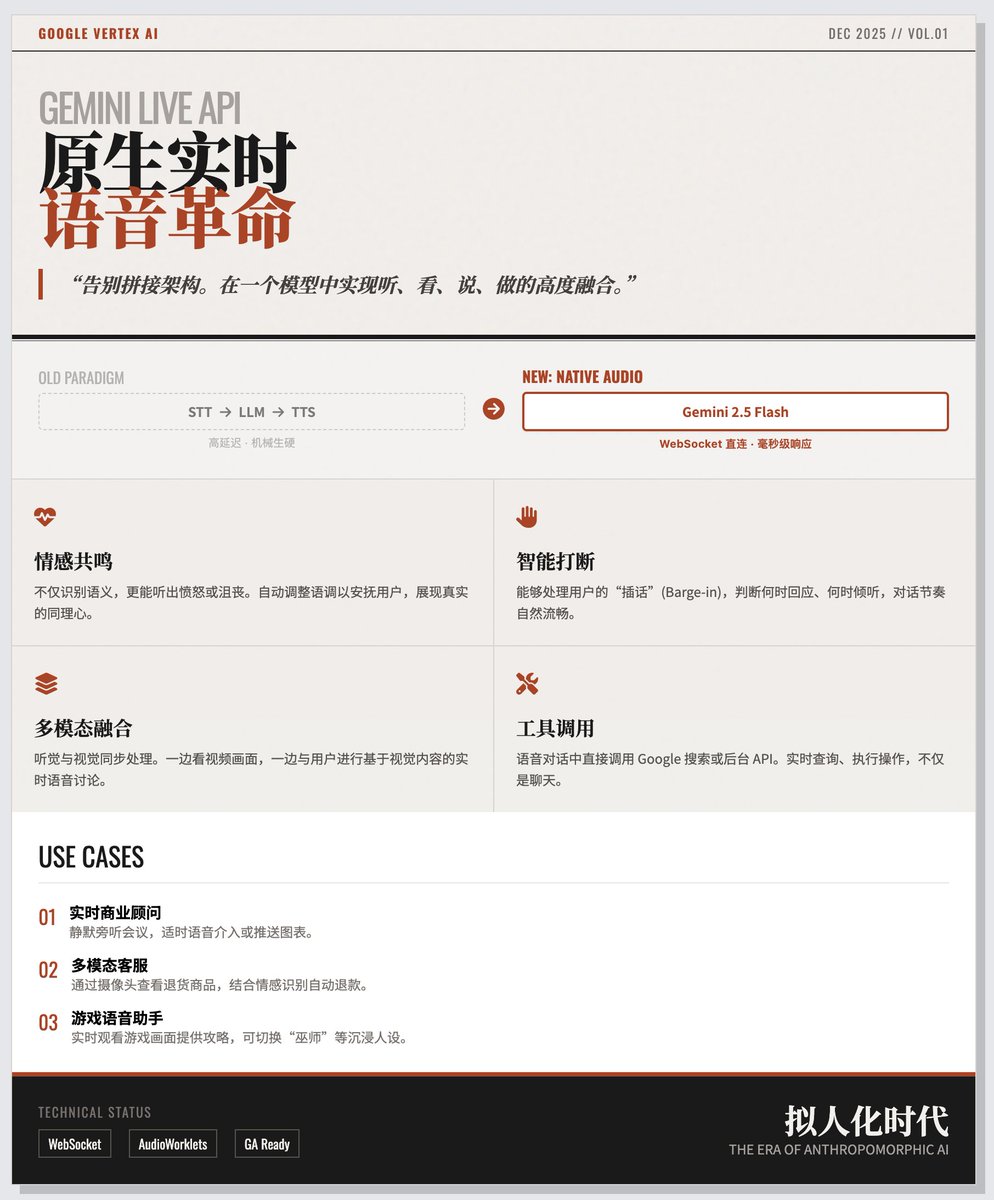
谷歌宣布了Gemini实时API、交互API以及新的多模态代理。- Gemini实时API使用Gemini 2.5 Flash原生音频模型。- 原生音频处理消除了STT/TTS链条并降低了延迟。- 实时API在一个WebSocket流中处理音频、视频和文本。- 功能:情感检测、可中断响应、工具调用、持久记忆。- 快速入门模板:Vanilla JS和React。- 演示应用:实时商业顾问、多模态客户服务、游戏语音助手。- Gemini TTS允许提示控制的语音属性(性别、语调、年龄、发音)。- 基于Gemini 3 Pro构建的Gemini深度研究代理用于自主规划和可验证引用。- 深度研究在DeepSearchQA、Humanity's Last Exam和BrowseComp上获得了SOTA成绩。
Key insights
Gemini实时API提供原生音频多模态低延迟管道
谷歌发布了基于Gemini 2.5 Flash原生音频的Gemini实时API,启用了一个单模型流,能够“听取”原始音频并直接生成音频响应,消除了单独的STT和TTS步骤。该API使用WebSocket连接实现毫秒级延迟,支持情感识别和可中断对话,并能够在实时对话中调用外部工具和进行搜索。谷歌提供了模板(Vanilla JS、React)和演示场景,以加速开发者的采用。
Gemini TTS和语音控制扩展多模态表现力
谷歌的新Gemini TTS模型接受提示级别的控制,允许调整语音属性,包括性别、语调、年龄和特定单词的发音,消除了更换语音模型的需要。开发者报告称,使用TTS为互动媒体生成独特的角色声音,将Gemini图像模型与TTS语音控制结合用于场景视觉。
Gemini深度研究代理旨在自主进行严谨研究并提供引用
DeepMind推出了基于Gemini 3 Pro构建的Gemini深度研究代理,旨在自主规划研究、执行针对性搜索、阅读结果、识别空白并重新查询。它将私有文档与公共来源整合,旨在提供可验证的输出和明确的引用。该代理在内部发布的DeepSearchQA(66.1%)、Humanity's Last Exam(46.4%)和BrowseComp(59.2%)上获得了SOTA成绩,并可通过交互API访问。
Gemini平台向开发者展示工具选择和UI行为
开发者解释了选择“创建图像”选项如何影响工具调用:未选中时,LLM可能仍会在上下文指示的情况下调用图像工具;选中时,系统提示强制执行图像生成。Gemini应用和其他聊天应用将原始LLM API与工具定义、搜索连接器和UI行为包装在一起,以确定何时以及调用哪些外部工具。