
面向长上下文智能体的记忆系统
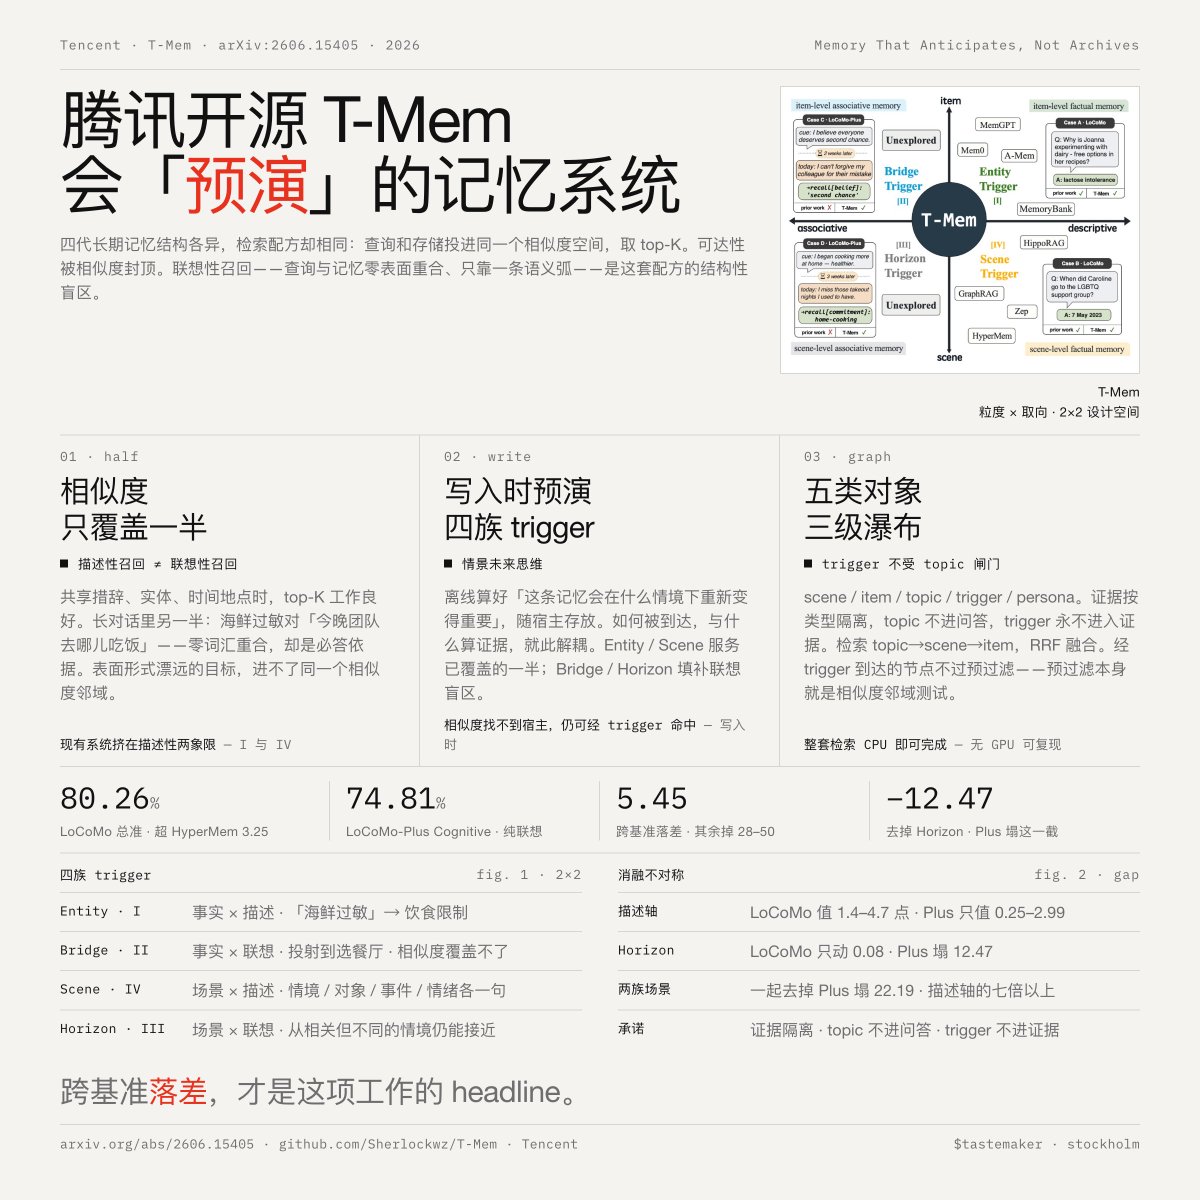
腾讯的T-Mem记忆系统针对长上下文智能体,解决了现有记忆架构中的结构性盲点——当查询与存储记忆在表面特征上无相似性时的联想回忆问题。该系统在写入时生成“触发器”以创建联想入口,在LoCoMo上准确率达80.26%,在LoCoMo-Plus认知子集上达74.81%,优于HyperMem和MemOS。
Key insights
相似性搜索限制了记忆检索的可达性
四代记忆架构(扁平RAG、图记忆、智能体分层、操作系统风格记忆内核)均使用相同的检索方法:将查询和存储内容投影到同一相似性空间,并取前K个结果。这使可达性受限于相似性层面,导致检索的联想部分成为结构性盲点。
触发器在写入时创建联想入口
T-Mem借鉴认知科学中的情景未来思维:在写入记忆时,构建器LLM生成“触发器”——对记忆在未来情境中重要性的预测。四类触发器覆盖设计空间:实体(事实描述型)、桥梁(事实联想型)、场景(情境型)和远景(情境联想型)。其中桥梁和远景填补了联想盲点。
LoCoMo-Plus认知子集显示决定性优势
在专为探测纯联想回忆设计的认知推理问题上,T-Mem得分为74.81%,而HyperMem为48.63%,MemOS为32.67%,GPT-4o零样本为21.05%,Gemini-2.5-Pro为26.06%。跨基准下降仅为5.45个百分点,而其他模型为28.38-50.07个百分点,证明扩展骨干模型无法修复有缺陷的联想回忆。
消融不对称性验证了联想轴的重要性
移除描述轴组件在LoCoMo上造成1.4-4.7分的损失,但在LoCoMo-Plus上仅损失0.25-2.99分。移除远景触发器几乎不影响LoCoMo(0.08分),但导致LoCoMo-Plus下降12.47分;移除两个场景级触发器则下降22.19分——影响是任何描述轴组件的七倍以上。这直接表明基于相似性的基准在结构上无法检测联想失败。
效率:仅CPU检索与离线构建成本
构建是一次性离线成本:10个LoCoMo对话需要9,689次模型调用和1560万token,高于Mem0的1220万token,原因是桥梁和远景触发器。在回答时,token预算低于HyperMem,同时在两个基准上准确率更高。完整检索在CPU上运行,可在无GPU的单工作站上复现。